Matemáticas · Tema 5 de 6
Estadística y probabilidad
La estadística es uno de los temas con más preguntas en Matemáticas del Saber 11. Casi siempre hay una tabla o un gráfico, y la clave está en leer bien qué representa cada eje antes de calcular.
Índice de contenido
- 1. Población, muestra y variables
- 2. Organizar datos y calcular frecuencias
- 3. Elegir y leer el gráfico adecuado
- 4. Detectar comparaciones engañosas
- 5. Media, mediana y moda
- 6. Promedios ponderados y datos agrupados
- 7. Medir cuánto se separan los datos
- 8. Cuartiles, percentiles y diagramas de caja
- 9. Relación entre dos variables
- 10. Muestreo, estimación y margen de error
- 11. Conjuntos: pertenencia, unión e intersección
- 12. Contar posibilidades sin enumerarlas todas
- 13. Experimentos aleatorios y espacios muestrales
- 14. Complemento, unión y sucesos incompatibles
- 15. Probabilidad condicionada: cambiar el grupo de referencia
- 16. Independencia, reposición y árboles de probabilidad
- 17. Repeticiones: al menos uno y exactamente varios
- 18. Valor esperado e interpretación de resultados
- Ejemplos resueltos paso a paso
- Ejemplo 1. Reconstruir un recuento desde un porcentaje
- Ejemplo 2. Comparar media, mediana y moda
- Ejemplo 3. Combinar grupos de distinto tamaño
- Ejemplo 4. Estimar la media de un histograma
- Ejemplo 5. Distinguir centro y dispersión
- Ejemplo 6. Obtener cuartiles y rango intercuartílico
- Ejemplo 7. Contar y condicionar en una encuesta
- Ejemplo 8. Elegir un equipo o asignar cargos
- Ejemplo 9. Dos azules con y sin reposición
- Ejemplo 10. Al menos un seis en dos lanzamientos
- Ejemplo 11. Exactamente dos aciertos independientes
- Ejemplo 12. Revisar una afirmación de mayoría
- Errores frecuentes y cómo evitarlos
- Lo que debes recordar
- Autoevaluación: cinco preguntas originales
- Respuestas y explicaciones
Aprenderás a organizar datos, interpretar gráficos, comparar promedios y medir la dispersión. También calcularás probabilidades, distinguirás situaciones con y sin reposición y evaluarás conclusiones basadas en muestras. Cada procedimiento explicará qué se cuenta, por qué se elige una operación y cómo comprobar el resultado.
1. Población, muestra y variables
Definir a quiénes se quiere estudiar
La población es el conjunto completo de personas, objetos o casos sobre el que se plantea una pregunta. La muestra es el subconjunto que se observa. Si un colegio tiene 600 estudiantes y se encuesta a 60, la población son los 600 y la muestra son los 60 encuestados. La unidad estadística es cada estudiante. Un censo observa toda la población; una encuesta por muestreo observa solo una parte.
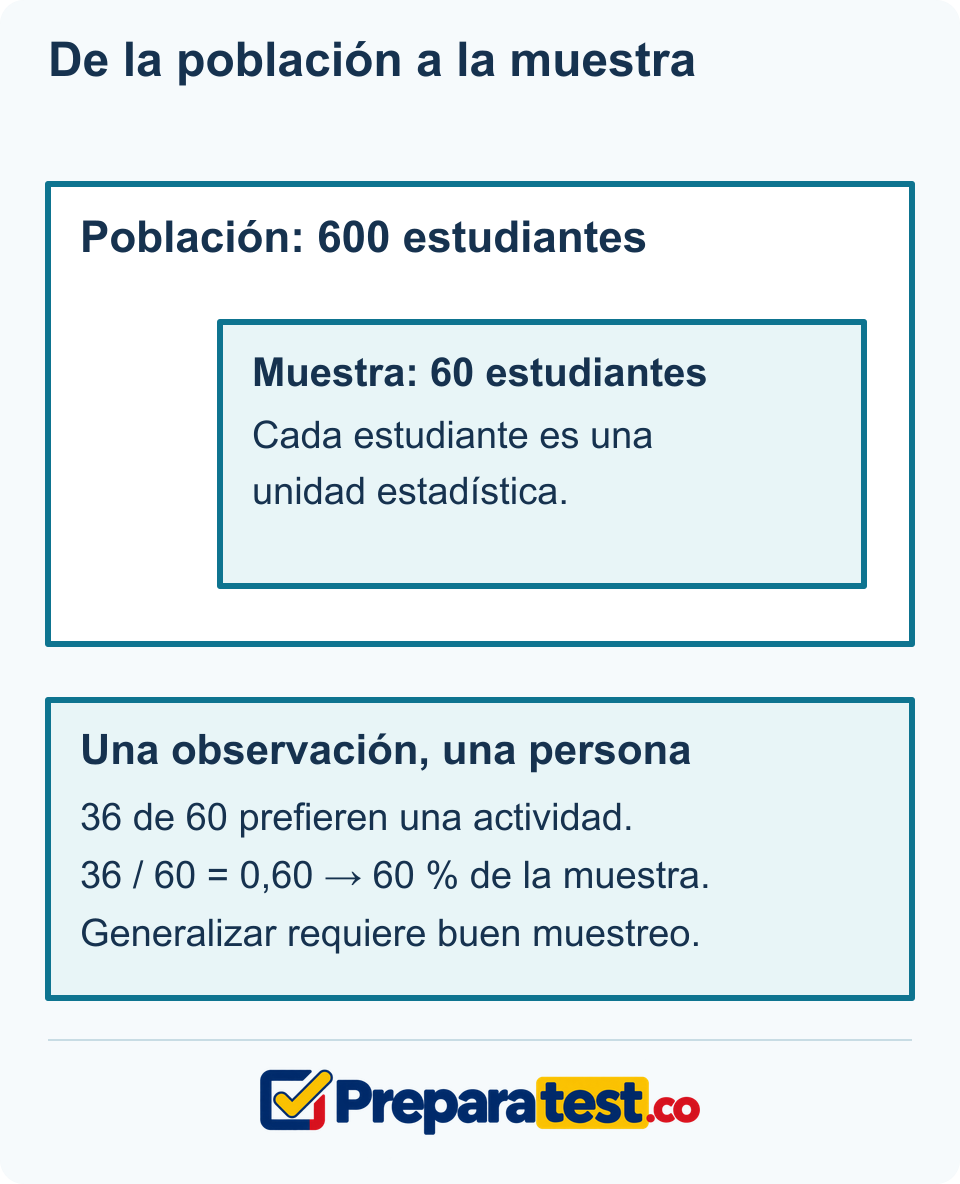
La muestra forma parte de la población. Para interpretar una conclusión, identifica primero a quiénes se estudió y a quiénes se pretende describir.
Una característica calculada para toda la población es un parámetro; la calculada con una muestra es un estadístico. Describir lo observado no es lo mismo que generalizarlo: que 36 de los 60 encuestados prefieran cierta actividad no prueba que exactamente 360 de los 600 estudiantes la prefieran. Esa cifra sería una estimación que depende de cómo se eligió la muestra.
Reconocer qué tipo de dato se recoge
Una variable cualitativa describe categorías: el medio de transporte es nominal porque no tiene un orden natural; un nivel de satisfacción —bajo, medio, alto— es ordinal. Una variable cuantitativa discreta cuenta valores separados, como el número de hermanos. Una cuantitativa continua mide una magnitud que puede tomar valores intermedios, como el tiempo de desplazamiento.

El tipo de variable ayuda a elegir el gráfico y las operaciones. No tiene sentido promediar códigos numéricos que solo identifican categorías.
La forma de registrar un dato no cambia por sí sola la magnitud que se estudia: un tiempo redondeado a minutos sigue procediendo de una medición continua. Antes de calcular, aclara qué representa cada número.
2. Organizar datos y calcular frecuencias
Contar sin perder observaciones
La frecuencia absoluta de un valor cuenta cuántas veces aparece. La frecuencia relativa divide ese recuento entre el total de observaciones. Para obtener el porcentaje, se multiplica la frecuencia relativa por 100. Usaremos una encuesta a 20 estudiantes sobre libros leídos durante un mes: 2 no leyeron libros, 6 leyeron uno, 8 leyeron dos y 4 leyeron tres.

Cada observación pertenece a una sola categoría. La suma de los cuatro recuentos debe devolver los 20 estudiantes.
- Comprueba el total: .
- Para dos libros, la frecuencia absoluta es . Divide entre todos los encuestados: .
- Convierte a porcentaje: . El 40 % de los estudiantes leyó dos libros.
- Repite con las otras categorías: 10 %, 30 % y 20 %. La suma es %.

La misma cantidad puede expresarse como recuento, fracción o porcentaje. Los porcentajes se calculan con el total de estudiantes, no con el total de libros.
Acumular cuando existe un orden
La frecuencia acumulada suma los recuentos hasta un valor incluido. Hasta un libro hay estudiantes; hasta dos, . Por eso el 80 % leyó como máximo dos: . En cambio, al menos dos reúne las categorías dos y tres: estudiantes, el 60 %. Las palabras “como máximo”, “menos de” y “al menos” deciden qué valores se incluyen.

La acumulada nunca disminuye y termina en el tamaño de la muestra. Acumular categorías sin orden, como colores, depende de un orden arbitrario y suele carecer de interés.
Los porcentajes exactos suman 100 %. Al redondearlos por separado pueden sumar 99,9 % o 100,1 %; una diferencia pequeña puede deberse al redondeo. Una diferencia grande exige revisar categorías, total y posibles respuestas múltiples.
3. Elegir y leer el gráfico adecuado
Barras para comparar categorías
Un gráfico de barras compara recuentos o porcentajes de categorías. Lee el título, los ejes y la unidad antes de mirar las alturas. En una elección de un solo club por estudiante, 12 eligen ajedrez, 18 música, 6 robótica y 4 teatro. La barra de música llega a 18: representa estudiantes, no un 18 %.
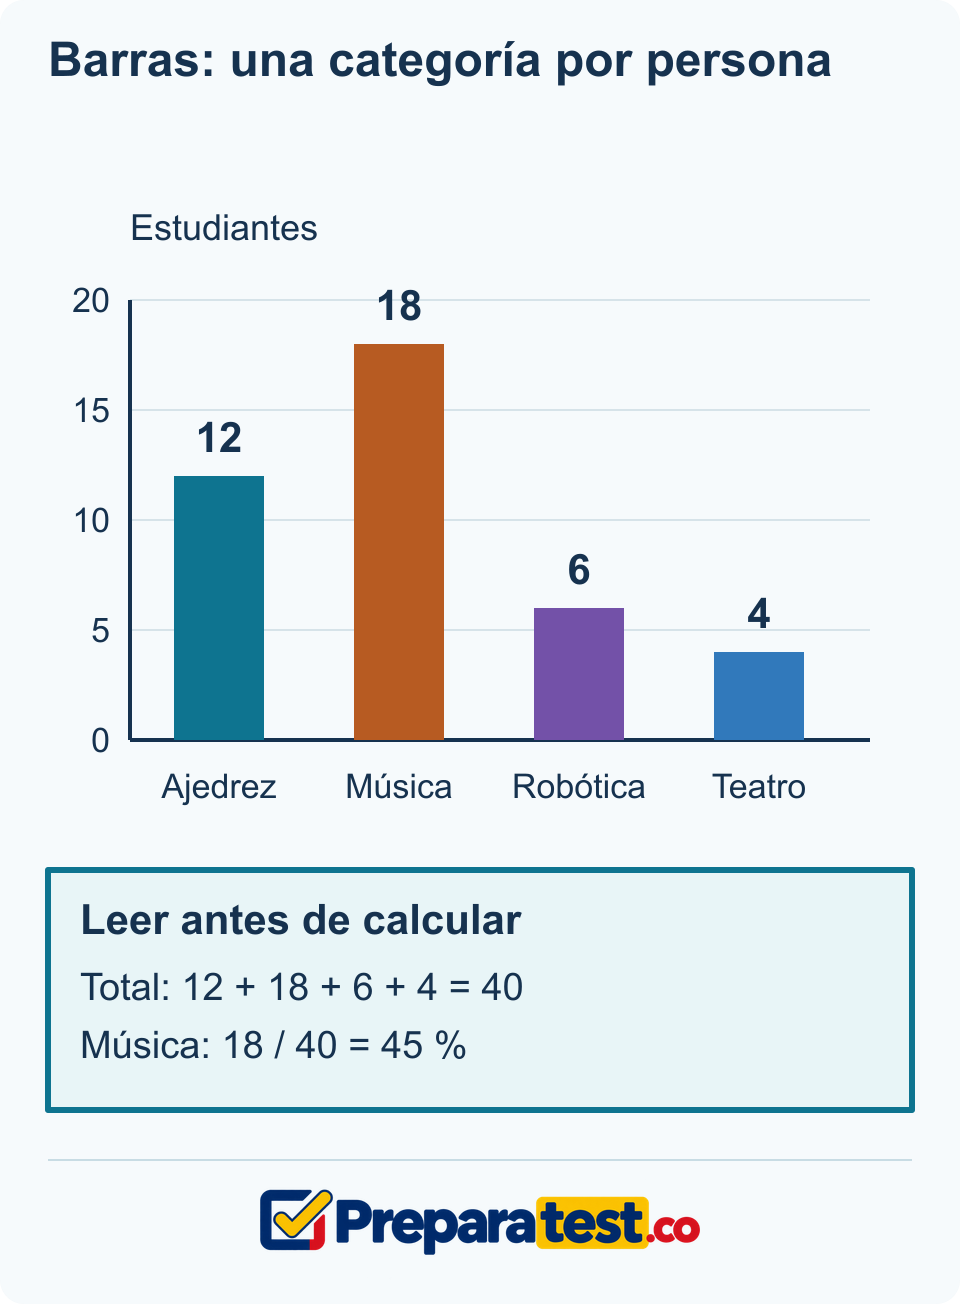
Las barras separadas muestran categorías distintas. Su eje de frecuencias empieza en cero para que las longitudes representen correctamente los recuentos.
El total es . Música reúne , es decir, el 45 %. Supera a ajedrez en estudiantes. La diferencia se calcula restando; la proporción se calcula dividiendo.
Sectores para partes de un mismo total
Un gráfico circular reparte el total en sectores. El círculo completo representa 100 % y mide . Para convertir una frecuencia en ángulo, calcula . Ajedrez representa , y su ángulo es . Música ocupa , robótica y teatro .

Los cuatro sectores corresponden a los mismos 40 estudiantes del gráfico de barras. Se usan categorías excluyentes que, juntas, cubren todo el grupo.
Líneas para observar cambios en el tiempo
Un gráfico de líneas conecta observaciones ordenadas, por ejemplo asistencia mensual. La posición horizontal identifica el momento; la vertical, la cantidad. Una subida indica aumento, una bajada disminución y un tramo horizontal ausencia de cambio entre los datos registrados. No supone que se conozcan todas las observaciones intermedias.
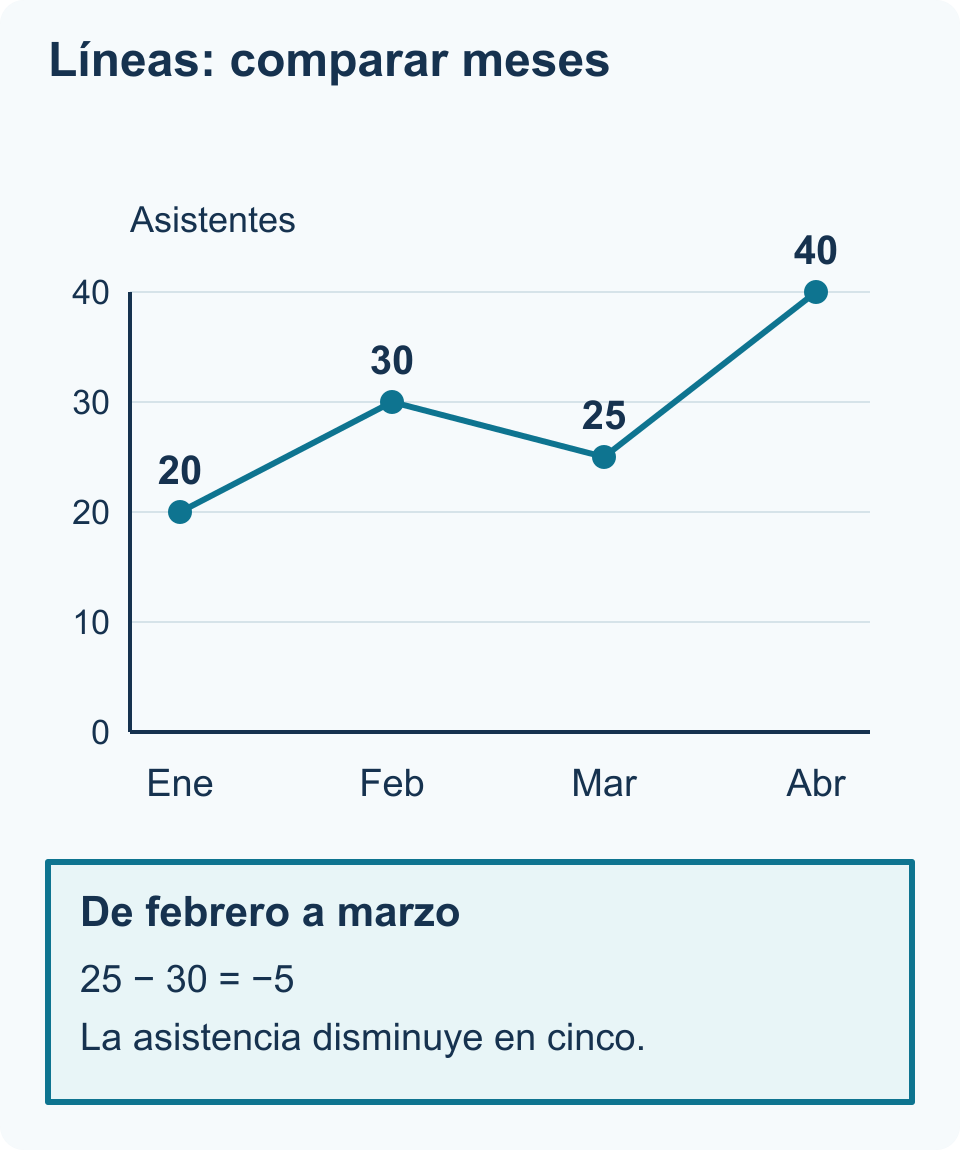
Entre febrero y marzo la asistencia baja de 30 a 25: disminuye en 5. Entre marzo y abril aumenta en 15. Los meses están igualmente separados en el eje.
Histogramas para datos agrupados en intervalos
Un histograma representa una variable cuantitativa agrupada en intervalos contiguos. Aquí los tiempos de llegada se agrupan en intervalos de 10 minutos: de 0 incluido a 10 excluido, de 10 a 20, de 20 a 30 y de 30 a 40. Los recuentos son 4, 8, 6 y 2. El dato 10 pertenece al segundo intervalo, de modo que nunca se cuenta dos veces.

Como los intervalos tienen la misma amplitud, las alturas pueden mostrar directamente las frecuencias. Los rectángulos se tocan porque representan intervalos contiguos.
Si las amplitudes son distintas, la frecuencia debe ser proporcional al área de cada rectángulo. Se puede usar una altura igual a frecuencia dividida entre amplitud, llamada densidad de frecuencia. No compares solo alturas sin leer cómo está construido el histograma.
4. Detectar comparaciones engañosas
Revisar el origen y los intervalos del eje
Si dos grupos tienen 40 y 50 participantes, el segundo tiene más. En relación con el primero, el aumento es , un 25 %. Si el dibujo recorta el eje y lo inicia en 30, las barras visibles miden 10 y 20 unidades: parecen tener una relación de dos a uno aunque los datos reales no la tengan. Los números del eje permiten descubrirlo.
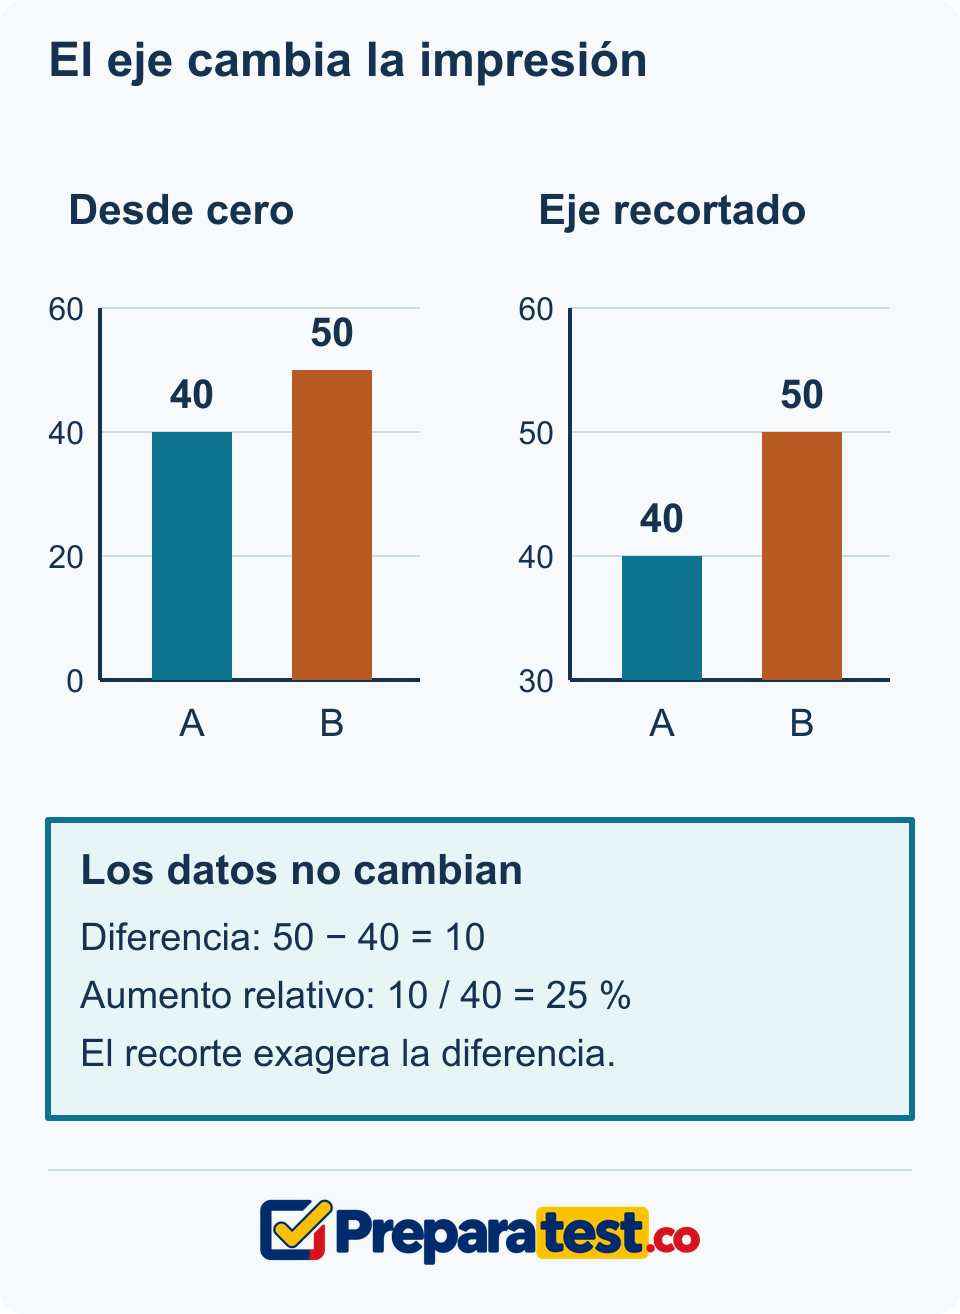
Las dos vistas contienen los mismos datos. La vista recortada exagera visualmente la diferencia al hacer que las longitudes de las barras ya no partan de cero.
También comprueba si el eje avanza de diez en diez o de cien en cien, si hay cortes y si un pictograma representa una o varias personas. Agrandar el alto y el ancho de un icono a la vez multiplica su área; eso puede exagerar la comparación. En un gráfico de líneas un eje recortado puede ayudar a ver cambios pequeños, pero debe señalarse y leerse con cuidado.
Comparar porcentajes con el denominador adecuado
En el grupo A aprueban 30 de 50 estudiantes; en el B, 40 de 100. B tiene más aprobados en número, pero A tiene mayor proporción: % frente a %. La diferencia es 20 puntos porcentuales. El 60 % es un 50 % mayor que el 40 %, porque . No son la misma forma de comparar.
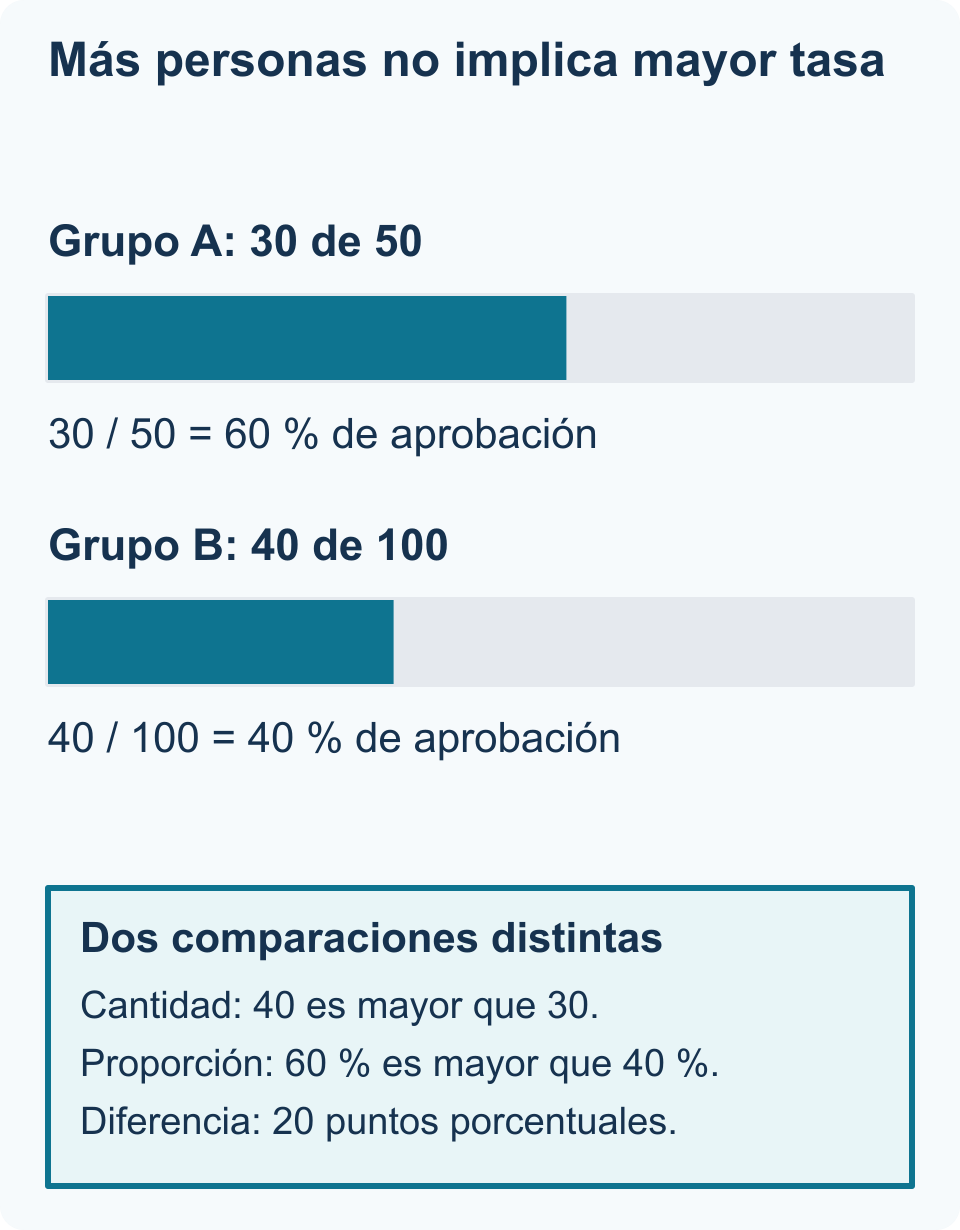
Para comparar grupos de tamaños distintos, observa tanto el recuento como la proporción. Di siempre qué total sirve de referencia.
Antes de aceptar una conclusión, pregunta qué datos la sostienen. “Hay más aprobados” y “la tasa de aprobación es mayor” son afirmaciones diferentes y pueden señalar grupos distintos.
5. Media, mediana y moda
La media reparte el total por igual
La media aritmética suma los valores y divide entre su cantidad: . El símbolo significa sumar. Para 2, 3, 3, 5 y 7 libros, el total es . Hay cinco observaciones; por eso libros. La media describe un reparto equivalente; no exige que alguna persona tenga exactamente cuatro libros.
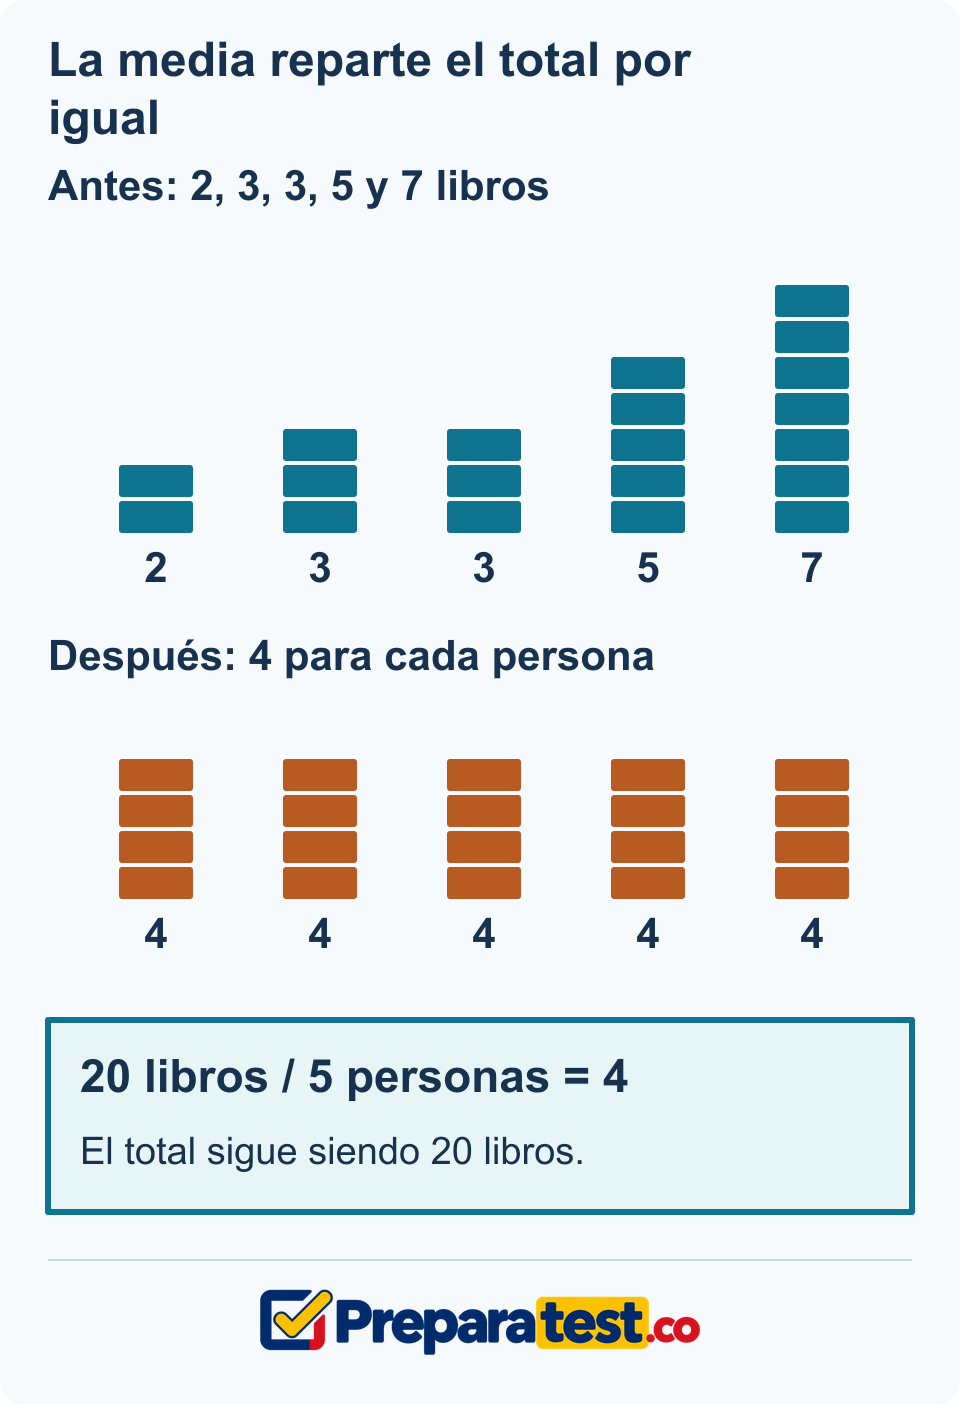
Redistribuir 20 libros entre cinco personas sin cambiar el total da cuatro por persona. La media conserva la suma: cantidad de datos por media igual a total.
La mediana ocupa el centro después de ordenar
La mediana localiza el centro de los datos ordenados. Con una cantidad impar, usa la posición . En 2, 3, 3, 5 y 7, la tercera observación es 3. Si la cantidad es par, promedia las dos observaciones centrales: en 2, 3, 5 y 8 son 3 y 5, de modo que la mediana es . No promedies la primera y la última.
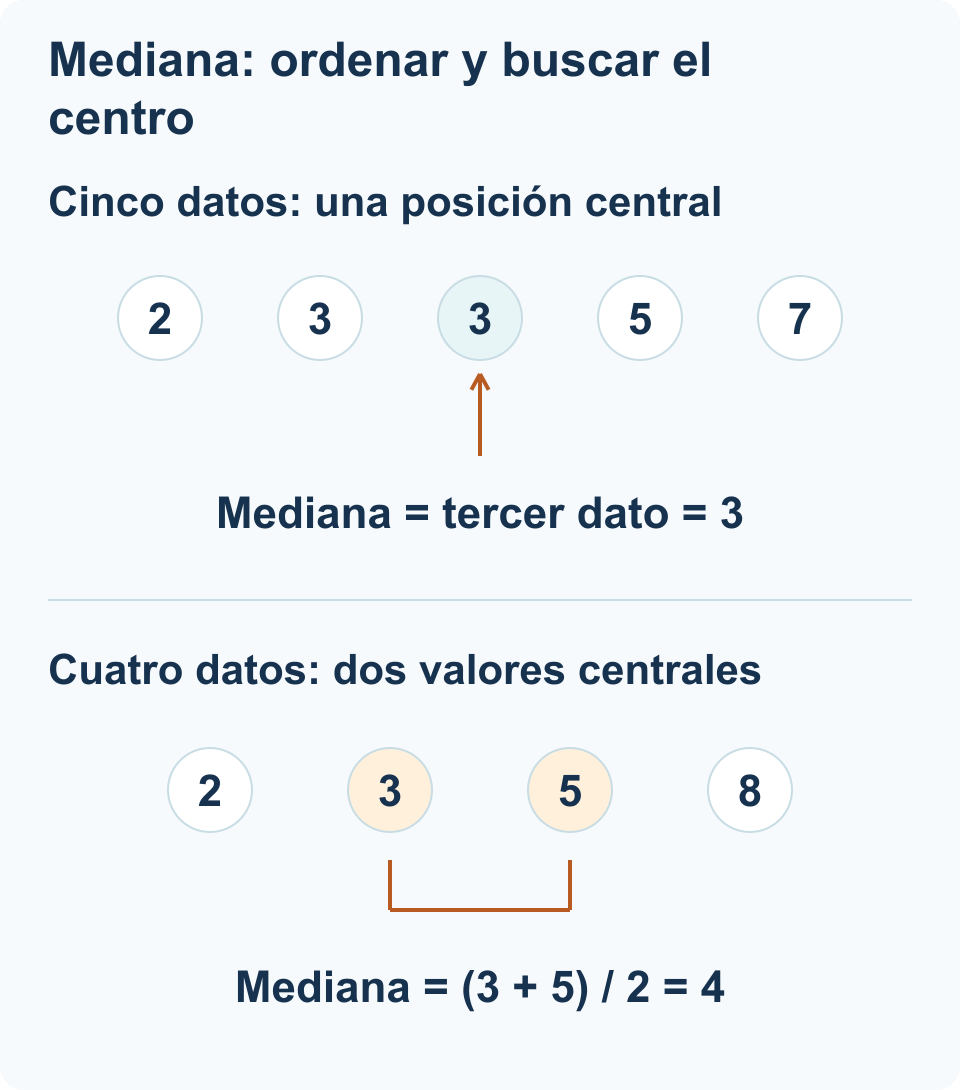
Primero ordena. La posición de la mediana se refiere al lugar en la lista; su valor es el dato que ocupa ese lugar, o la media de los dos centrales.
La moda identifica lo más frecuente
La moda es el valor o categoría que más se repite. En 2, 3, 3, 5 y 7 es 3. En 1, 1, 2, 2 y 4 hay dos modas, 1 y 2: la distribución es bimodal. En este tema diremos que no hay moda cuando todos los valores aparecen una sola vez. La moda sí permite resumir categorías, como el club preferido; la media no sirve para promediar nombres de clubes.
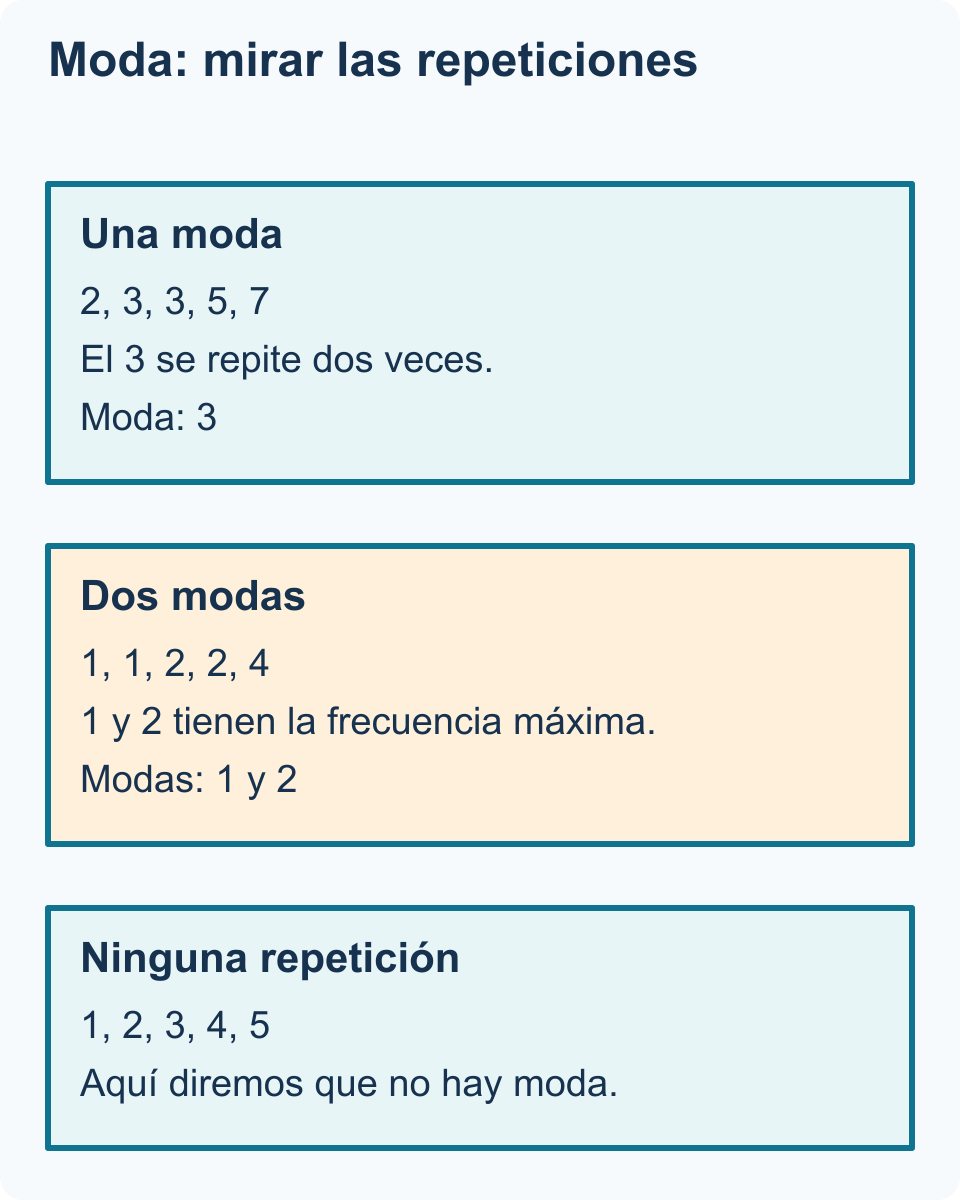
Busca la frecuencia más alta, no el número más grande. Si varios valores comparten la frecuencia máxima y esta es mayor que uno, hay varias modas.
Un valor extremo afecta especialmente a la media
Compara 2, 3, 3, 5, 7 con 2, 3, 3, 5, 27. Solo cambió el último dato. La suma pasa de 20 a 40 y la media, de 4 a 8; la mediana y la moda siguen siendo 3. La mediana puede describir mejor el centro cuando existe mucha asimetría o un dato extremo, pero ninguna medida resume por sí sola toda la distribución.
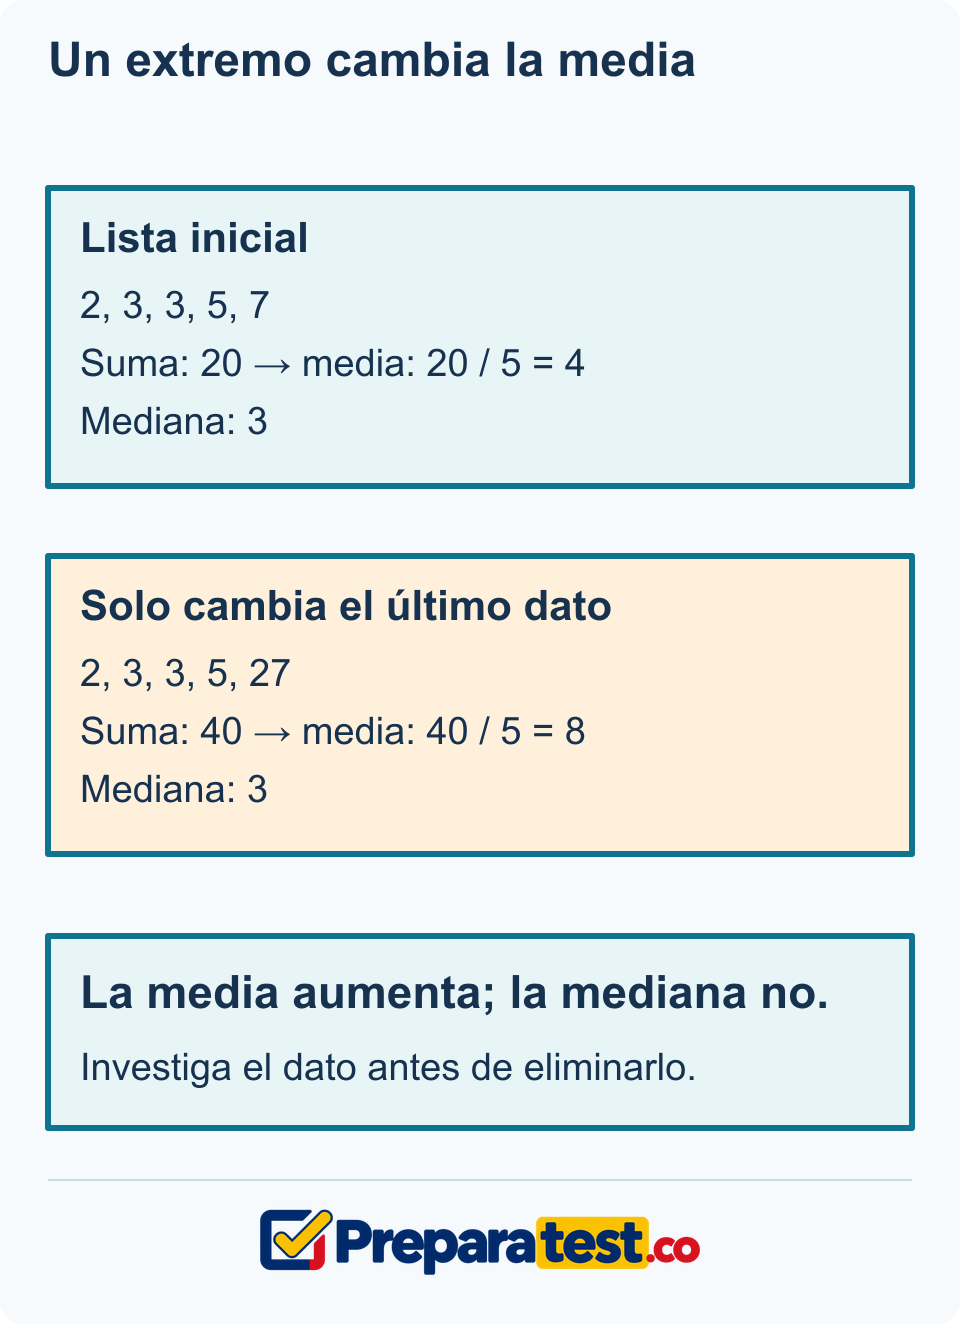
Un dato extremo no se elimina automáticamente: puede ser un error de registro o una observación real. Hay que comprobar su origen antes de decidir.
6. Promedios ponderados y datos agrupados
Dar a cada dato el peso que le corresponde
En una media ponderada, cada valor tiene un peso. Se calcula . Si una nota de 3,0 vale el 20 %, una de 4,0 el 30 % y una de 4,5 el 50 %, los pesos decimales suman 1. Multiplica cada nota por su peso: , y . La suma es 4,05.

Cada contribución combina la nota con su importancia. La nota de mayor peso influye más; no se divide otra vez entre tres cuando los pesos ya suman uno.
Para combinar medias de grupos, usa como pesos sus tamaños. Un grupo de 10 estudiantes con media 4 y otro de 30 con media 3 tienen suma de notas . La media conjunta es , no 3,5. Promediar directamente 4 y 3 solo sería válido si ambos grupos tuvieran el mismo tamaño.
Usar frecuencias sin reconstruir toda la lista
En la encuesta de libros, cada valor se multiplica por su frecuencia. Hay , , y libros, para un total de 34. La media es libros por estudiante. Para la mediana busca las posiciones 10 y 11 en las frecuencias acumuladas: ambas corresponden a dos libros. La mediana y la moda son 2.
Estimar cuando solo se conocen intervalos
Si solo conservas los intervalos de un histograma, ya no conoces cada dato exacto. La marca de clase es el punto medio del intervalo. Multiplicar cada marca por su frecuencia permite estimar la media, suponiendo que esa marca representa a las observaciones del grupo.

Las marcas 5, 15, 25 y 35 minutos representan los intervalos de amplitud 10. La media estimada es 18 minutos; los datos individuales podrían producir otra media exacta.
- Calcula las marcas: por ejemplo, minutos para el segundo intervalo.
- Multiplica por los recuentos: , , y .
- Suma: . Divide entre personas.
- La estimación es minutos. Identifícala como aproximada porque se usaron marcas en lugar de tiempos individuales.
7. Medir cuánto se separan los datos
La misma media puede ocultar distribuciones distintas
El rango es máximo menos mínimo. Los grupos 4, 4, 4, 4 y 2, 2, 6, 6 tienen media 4. Sin embargo, el primero tiene rango y el segundo . Para comparar resultados no basta mirar el promedio: también importa cuánto se alejan los valores del centro.

Cada punto representa una observación. Los puntos apilados indican datos repetidos; su altura no es el valor de la variable.
Varianza y desviación estándar
La varianza utiliza todos los datos: calcula la distancia de cada uno a la media, eleva esas diferencias al cuadrado y las promedia. Los cuadrados evitan que las diferencias positivas y negativas se cancelen. La desviación estándar es la raíz cuadrada de la varianza y recupera las unidades originales.
- Considera que los cuatro tiempos 2, 2, 6 y 6 minutos constituyen toda la población que se quiere describir. Su media es minutos.
- Para cada tiempo de 2 minutos, resta . Para cada tiempo de 6 minutos, resta . Las cuatro diferencias son −2, −2, 2 y 2.
- Eleva al cuadrado y suma: .
- Divide entre los cuatro datos: la varianza poblacional es .
- Extrae la raíz: . Es una medida de dispersión, no el tiempo promedio.
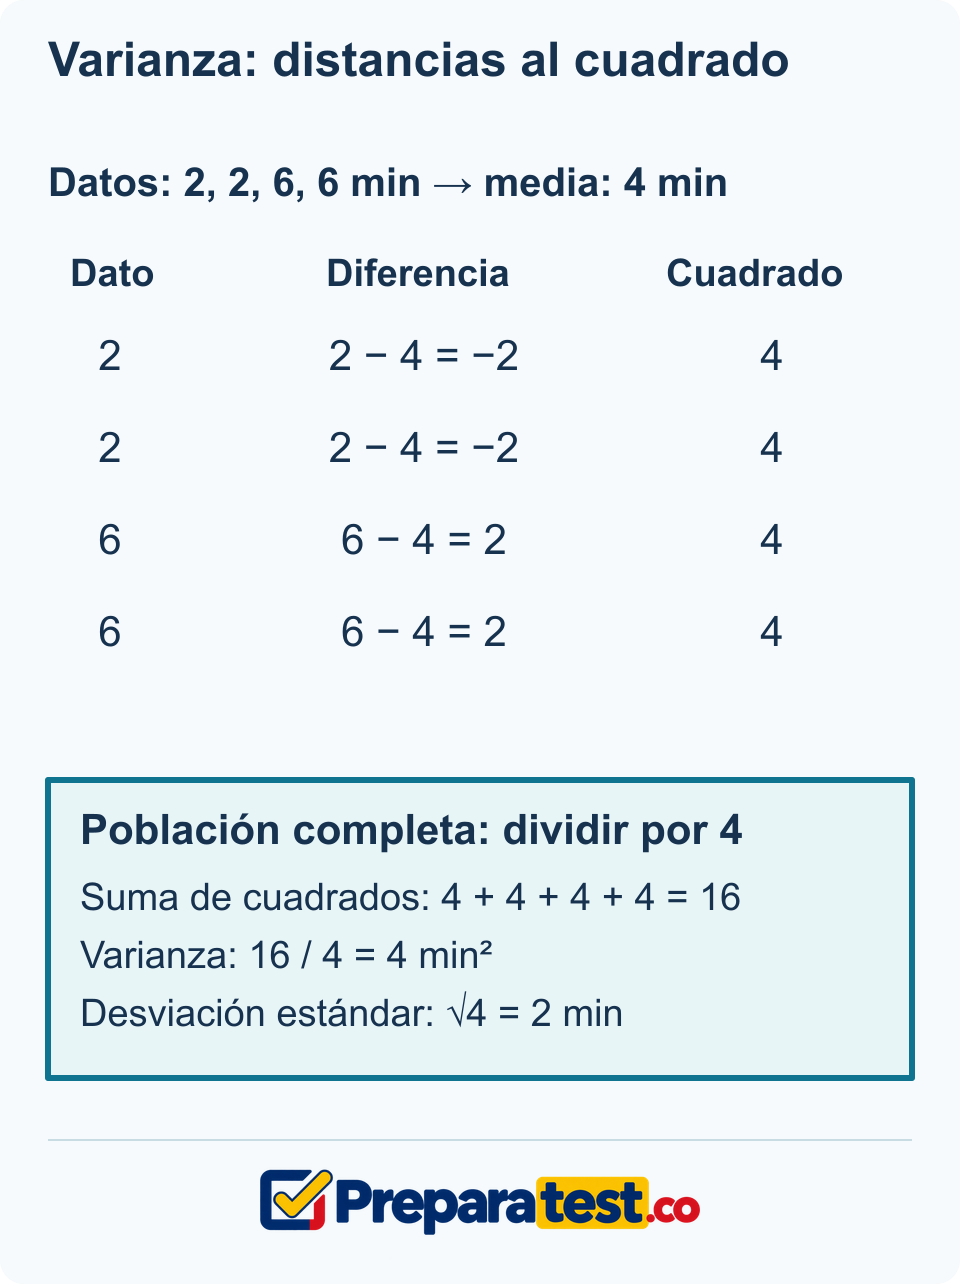
La varianza tiene unidades al cuadrado; la desviación estándar tiene las mismas unidades que los datos. Si todos los datos fueran iguales, ambas serían cero.
La fórmula poblacional es . Si los datos son una muestra usada para estimar la varianza de una población, se emplea habitualmente la varianza muestral corregida: , con . Para los mismos cuatro números, sería . El divisor depende del propósito y de lo que pida el enunciado; no se alternan las fórmulas sin explicarlo.
Una desviación de 2 minutos no significa que todos los tiempos estén exactamente a 2 minutos de la media ni que todos queden dentro de ese intervalo. Tampoco es un porcentaje. Su interpretación siempre depende de las unidades y de la distribución.
8. Cuartiles, percentiles y diagramas de caja
Dividir una lista ordenada en partes
Los cuartiles describen posiciones cercanas al 25 %, 50 % y 75 % de una distribución. En este tema calcularemos el segundo cuartil como la mediana; el primero como la mediana de la mitad inferior y el tercero como la mediana de la mitad superior. Si hay una cantidad impar de datos, excluiremos la mediana general de las dos mitades. Es una convención explícita; otros métodos pueden dar resultados distintos en muestras pequeñas.

La lista está ordenada. Las dos mitades se analizan por separado y la mediana general se obtiene con los dos valores centrales de la lista completa.
- Ordena los ocho datos: 2, 4, 4, 6, 10, 12, 12, 14.
- La mediana general es .
- La mitad inferior es 2, 4, 4, 6: . La superior es 10, 12, 12, 14: .
- El rango intercuartílico es . Describe la amplitud entre los cuartiles centrales y depende menos de los extremos que el rango total.
Leer una caja sin confundir posición y cantidad
En el diagrama de caja mostrado, la caja va del primer al tercer cuartil; la línea interior señala la mediana. Los bigotes llegan aquí al mínimo y al máximo. Algunos diagramas usan otro criterio para los bigotes y dibujan los valores atípicos por separado: hay que leer la leyenda. Una caja más larga indica un rango intercuartílico mayor, no necesariamente más personas.
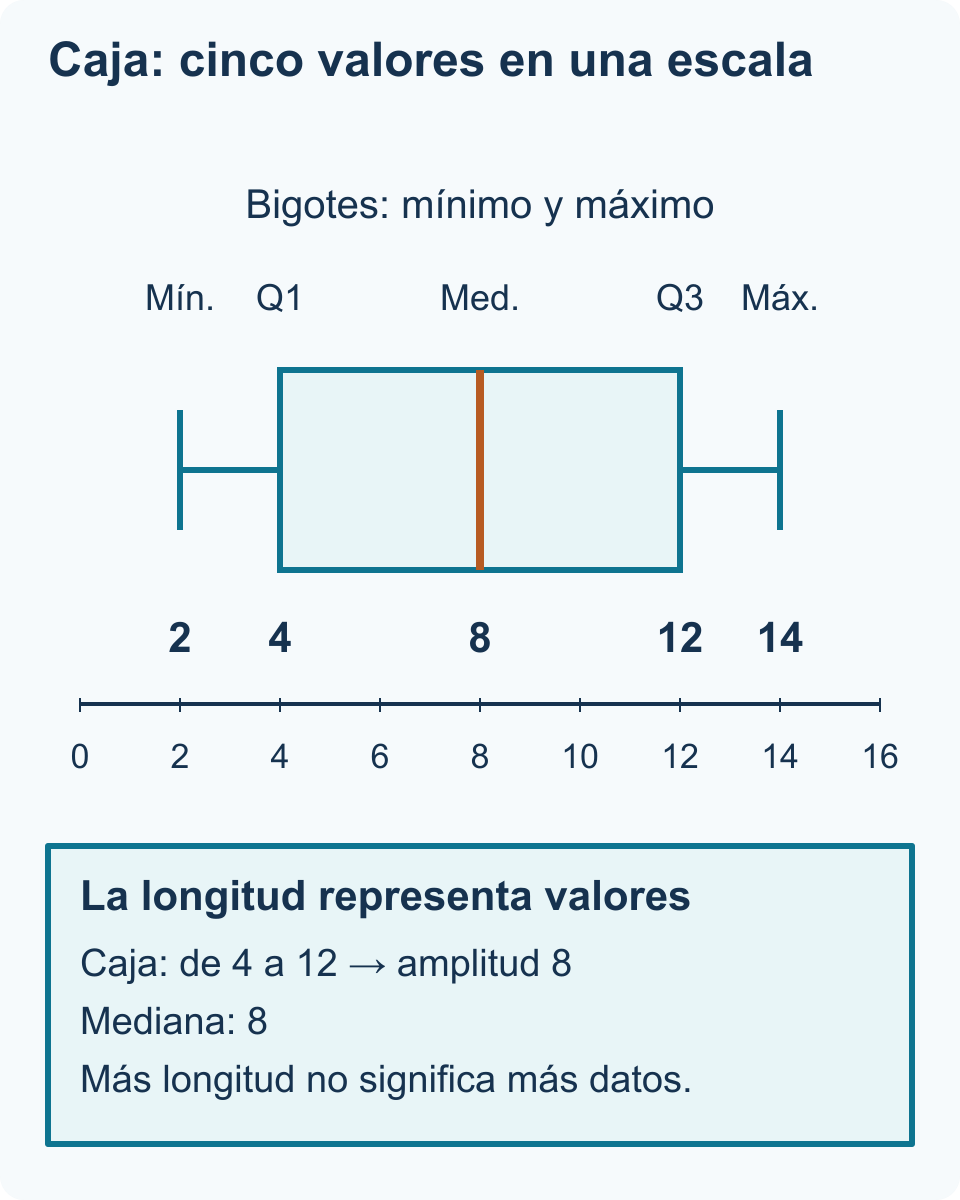
El eje mide valores de la variable. La caja resume posiciones, no reproduce todas las observaciones; los empates impiden interpretar cada tramo como un grupo exacto de personas distintas.
Calcular un percentil con una regla declarada
Un percentil señala una posición en los datos ordenados, no un porcentaje de respuestas correctas. Para el siguiente ejemplo usaremos la regla de rango más próximo: calcula para y toma el dato en la posición . Los símbolos indican redondear hacia arriba. Esta regla no es la misma que la de medianas de mitades usada antes para los cuartiles.

Con diez valores ordenados, el percentil 80 según esta regla está en la posición ocho. El resultado es un valor de la variable, no el número 80 %.
Para 10, 20, 30, 40, 50, 60, 70, 80, 90 y 100 puntos, , de modo que puntos. Si se pidiera el percentil 85, y resultaría 90 puntos. Con empates, la proporción situada estrictamente por debajo puede ser menor que el porcentaje indicado. Sigue siempre el método y la definición que dé el problema.
Un percentil informa sobre la posición respecto de un grupo de referencia. Cambiar ese grupo puede cambiar la posición aunque el valor individual sea el mismo. No confundas percentil 80 con haber contestado bien el 80 % de un examen.
9. Relación entre dos variables
Leer una nube de puntos
En un diagrama de dispersión, cada punto reúne dos datos de una misma unidad: por ejemplo, horas de práctica y ejercicios completados por una persona. Una tendencia ascendente sugiere asociación positiva; una descendente, negativa. Si la nube no sigue una dirección lineal clara, la asociación lineal puede ser débil. No unas los puntos como si describieran obligatoriamente una secuencia temporal.
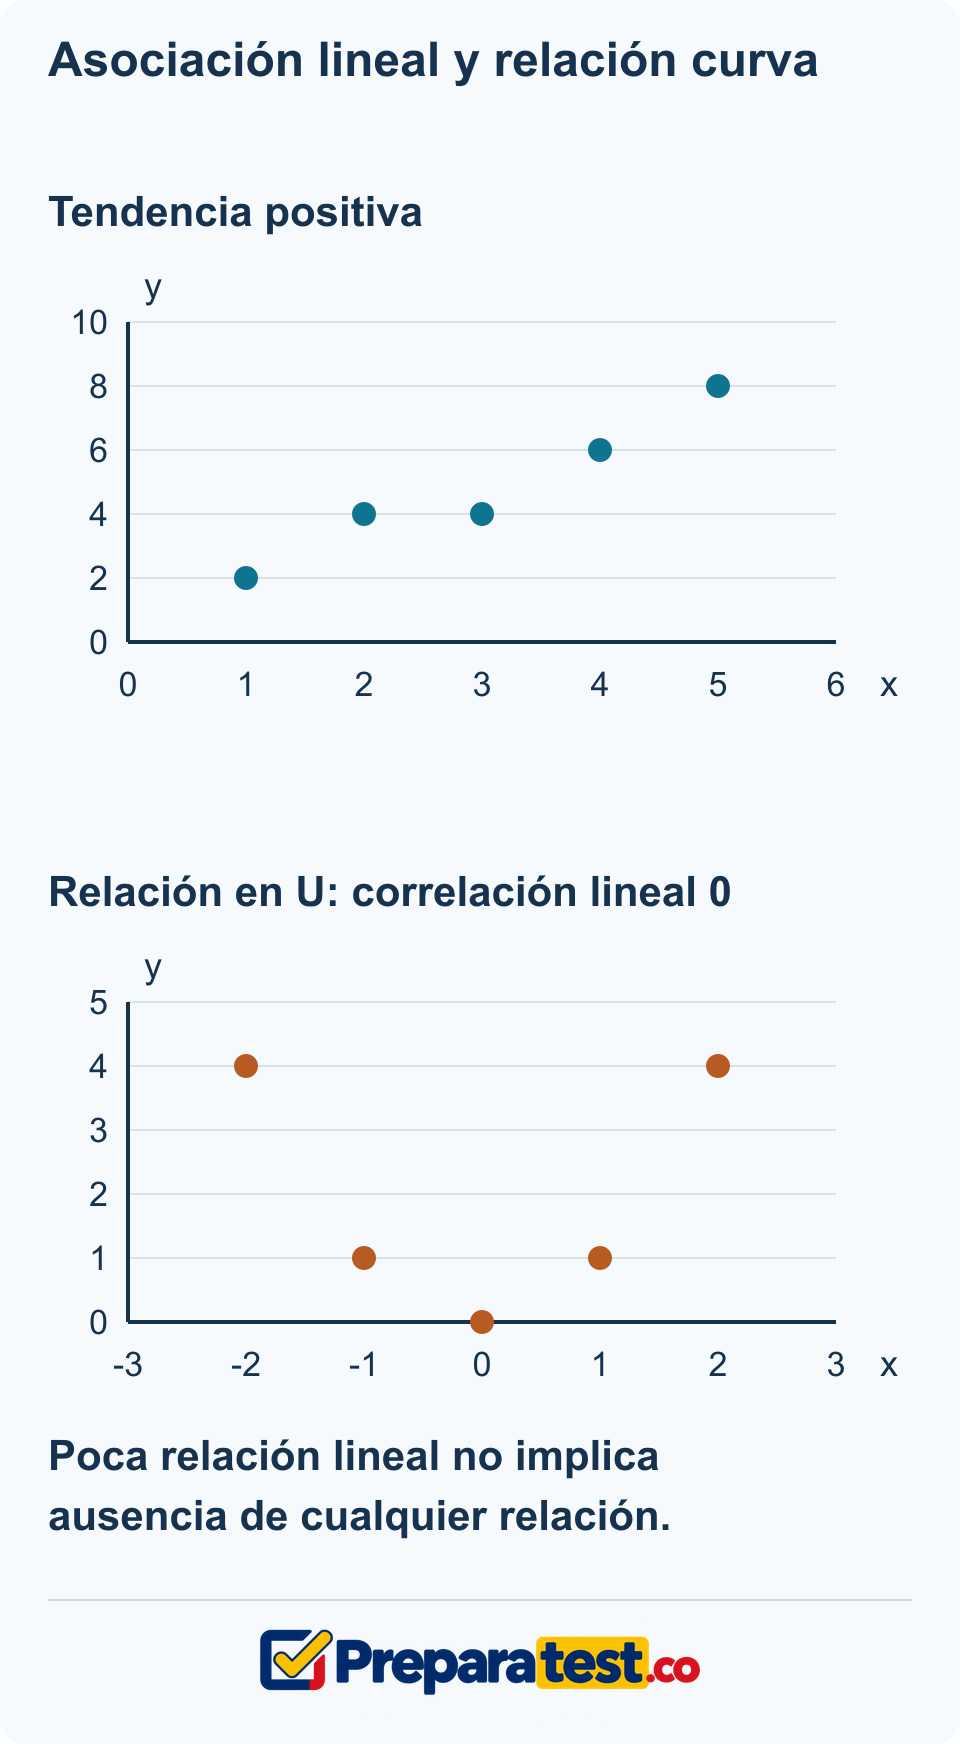
A la izquierda, al aumentar una variable la otra tiende a aumentar. A la derecha hay una relación en forma de U: una medida de asociación lineal puede no detectarla.
El coeficiente de correlación lineal de Pearson, , toma valores entre y , siempre que ambas variables tengan variación. Cerca de 1 indica asociación lineal positiva fuerte; cerca de −1, negativa fuerte. Un valor cercano a 0 indica poca asociación lineal, pero puede existir una relación curva. Si todos los valores de una variable son iguales, ese coeficiente no está definido.
Una asociación no demuestra una causa
Que dos cantidades aumenten juntas no demuestra que una produzca la otra. En días calurosos pueden crecer tanto la venta de helados como la asistencia a piscinas: la temperatura influye en ambas. También pueden intervenir selección de la muestra, coincidencias o una relación en sentido inverso. Para sostener una explicación causal hace falta un diseño y evidencia adicionales.
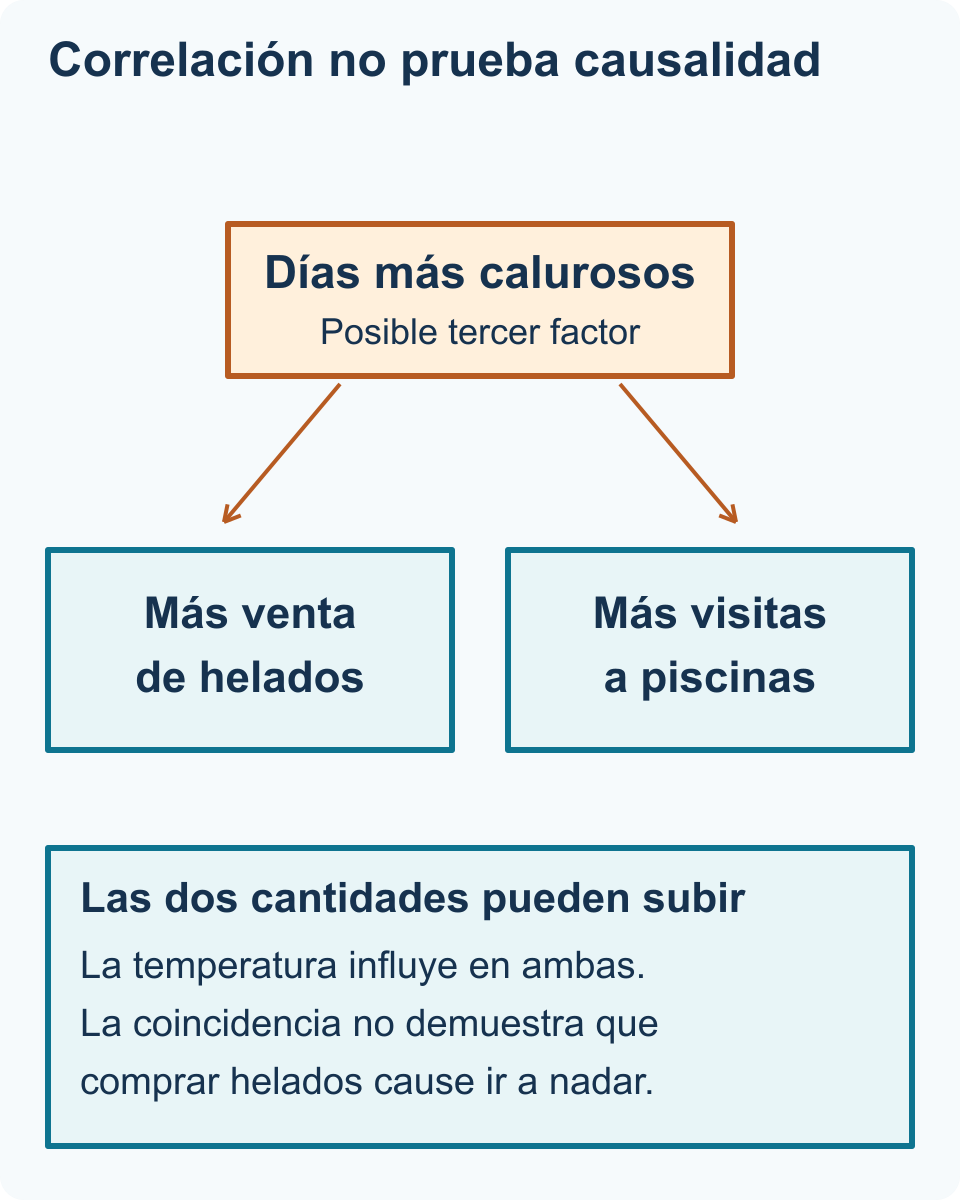
Una tercera variable puede explicar una asociación. El gráfico ilustra una posible explicación, no prueba por sí solo que ese sea el único mecanismo.
Una recta ajustada resume una tendencia y permite estimaciones dentro del contexto observado. Prolongarla muy lejos de los datos es una extrapolación y puede producir resultados poco fiables. Un ajuste no garantiza que el patrón continúe.
10. Muestreo, estimación y margen de error
El tamaño no corrige una selección sesgada
Una muestra de conveniencia incluye a quienes resultan más fáciles de contactar; una encuesta voluntaria incluye a quienes deciden responder. Ambas pueden representar mal a la población. Preguntar solo en un club de lectura sobre hábitos lectores puede sobreestimar la lectura del colegio. Aumentar mucho esa misma muestra no elimina el sesgo de selección.

Para estudiar todo el colegio hay que dar cobertura a todos sus grupos. Seleccionar al azar dentro de cada estrato reduce la dependencia de quién sea más fácil de encuestar.
En un muestreo aleatorio simple de tamaño fijo, todas las muestras posibles de ese tamaño tienen la misma probabilidad de ser elegidas. En uno estratificado, se divide la población en grupos y se selecciona dentro de cada grupo. Si tres grados tienen 300, 200 y 100 estudiantes, una muestra proporcional de 60 reserva , y lugares. Dentro de cada grado debe seguirse un método de selección adecuado.
Distinguir estimación, incertidumbre y sesgo
Una muestra puede dar una estimación distinta de otra aun si ambas se seleccionan correctamente: es la variabilidad muestral. Supón que 104 de 200 encuestados apoyan una propuesta. La proporción observada es , el 52 %. Si el informe proporciona un margen de error de 4 puntos porcentuales, el intervalo indicado va de % a %.
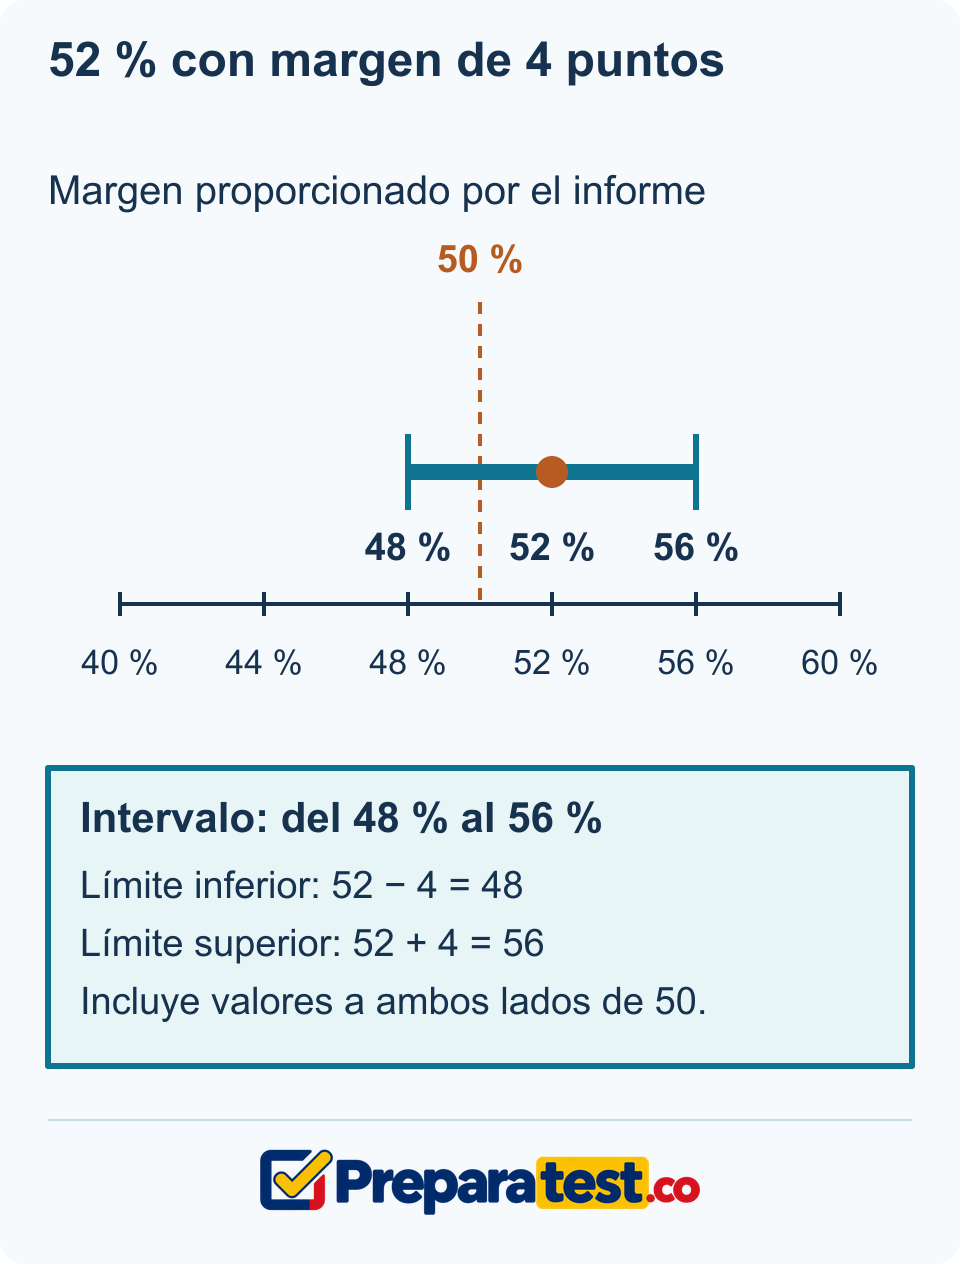
El margen de 4 puntos porcentuales lo proporciona el enunciado: no se ha deducido solo del tamaño 200. El intervalo incluye valores inferiores y superiores al 50 %.
No se puede afirmar una mayoría poblacional con claridad basándose solo en ese intervalo, porque incluye el 50 %. Si el informe habla de un 95 % de confianza, ese nivel describe el procedimiento: al repetir muchas veces el muestreo y construir intervalos del mismo modo, aproximadamente el 95 % contendría el valor poblacional, bajo las condiciones del método. No significa que el 95 % de las personas tenga la característica estudiada.
El margen de error habitual del muestreo no cubre automáticamente respuestas falsas, preguntas mal formuladas, falta de respuesta o exclusión de grupos. Un intervalo estrecho no rescata una encuesta sesgada.
11. Conjuntos: pertenencia, unión e intersección
Colocar primero la zona compartida
Un conjunto reúne elementos que cumplen una condición. El universo contiene todos los casos considerados. La intersección reúne los que pertenecen a ambos conjuntos. La unión reúne los que están en A, en B o en ambos. El complemento contiene los que no están en A, dentro del universo.
En un curso de 30 estudiantes, 18 practican fútbol, 12 baloncesto y 6 ambos. No se suman directamente 18 y 12 para hallar cuántos practican algún deporte: los seis de ambos se contarían dos veces.

Las cuatro regiones separadas suman 30. Los 18 de fútbol incluyen a los 6 que también practican baloncesto.
- Coloca los 6 de ambos deportes en la intersección.
- Solo fútbol: . Solo baloncesto: .
- Al menos uno: , o bien .
- Ninguno: . Comprueba todas las regiones: .
La inclusión no significa igualdad
La expresión significa que todo elemento de B pertenece también a A. Entre los enteros del 1 al 8, los múltiplos de 4 forman , incluido en el conjunto de pares . En ese caso, y . Ser par no obliga a ser múltiplo de 4.

El conjunto pequeño está completamente dentro del grande. La relación de inclusión permite simplificar una unión o una intersección sin volver a contar.
En matemáticas, “A o B” suele incluir la posibilidad de ambos. Si el problema pide exactamente uno, excluye la intersección: en el ejemplo deportivo son 12 más 6, es decir, 18 estudiantes.
12. Contar posibilidades sin enumerarlas todas
Sumar alternativas y multiplicar etapas
El principio de suma combina alternativas que no se superponen: si para un viaje eliges una de tres rutas de bus o una de dos rutas de tren, hay opciones de ruta. El principio de producto combina etapas: si eliges una camiseta entre tres y un pantalón entre dos, hay conjuntos, siempre que cada camiseta pueda combinarse con cualquiera de los pantalones.
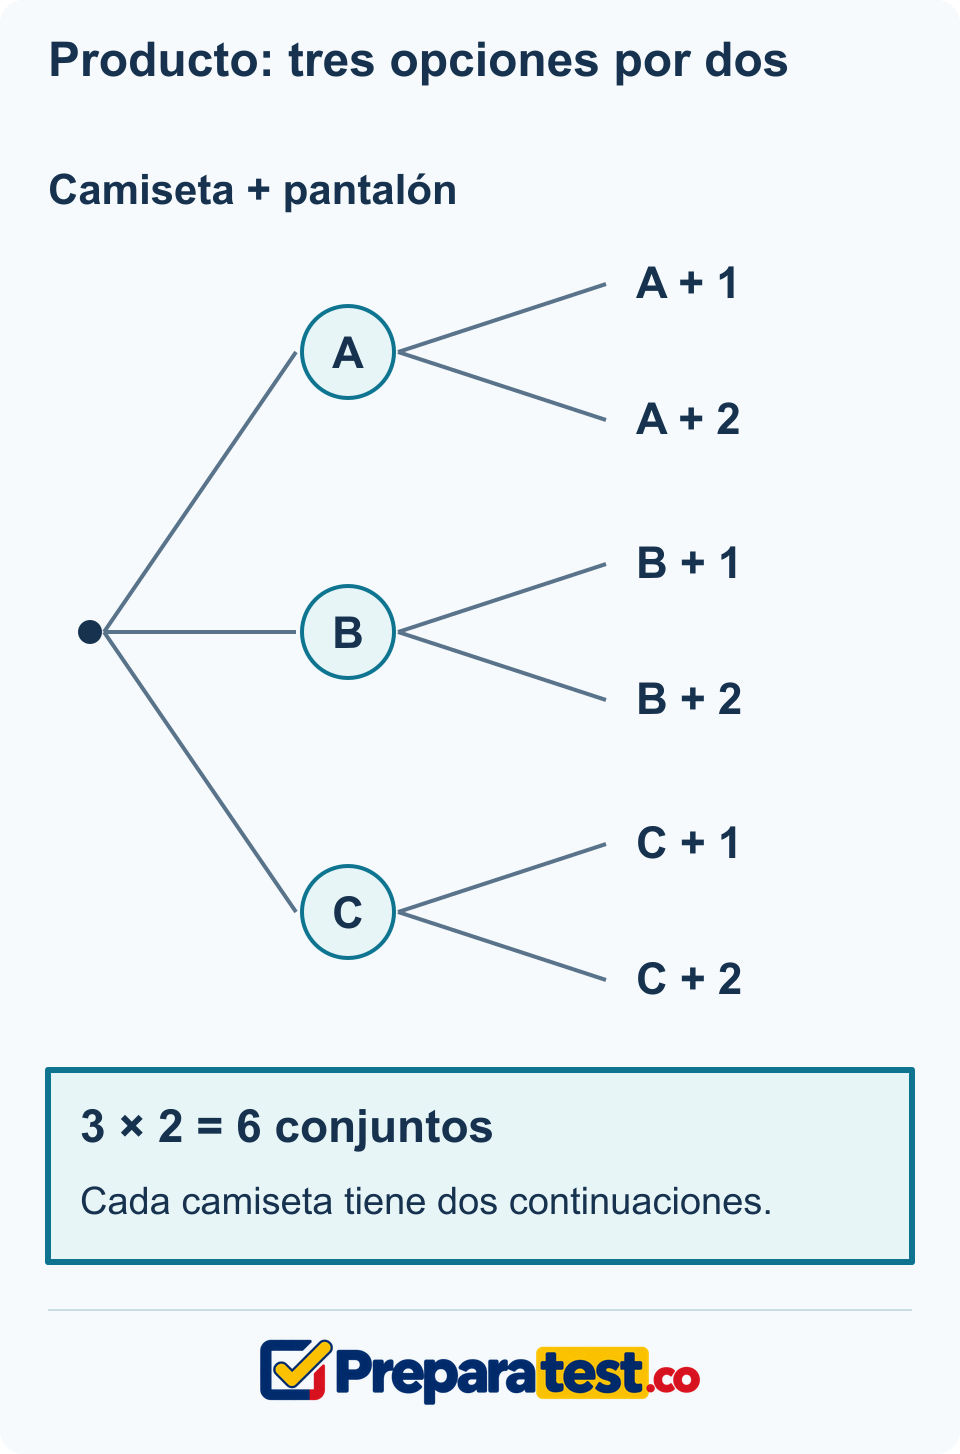
Cada una de las tres ramas iniciales tiene dos continuaciones. Se multiplica porque se elige una opción de cada etapa.
Distinguir orden y repetición
Para asignar presidencia y secretaría a dos de cuatro personas distintas, hay 4 opciones para el primer cargo y 3 para el segundo: . El orden importa porque Ana presidenta y Beto secretario no es la misma asignación que Beto presidente y Ana secretaria. Para elegir un equipo sin cargos, ambas listas representan el mismo grupo.

Antes de contar, decide si cambiar el orden produce una posibilidad nueva y si se permite repetir elementos.
El factorial se define como para enteros positivos y . Ordenar cuatro personas en fila da . Elegir y ordenar dos de cuatro sin repetición da . Con repetición permitida, un código de tres posiciones y cuatro símbolos disponibles tiene posibilidades; esto supone que cualquier símbolo puede ocupar cualquier posición.
Combinaciones: elegir sin dar cargos
Para elegir un grupo de elementos entre , sin repetición y sin importar el orden, se usa . En equipos de dos entre cuatro personas, el recuento ordenado da 12, pero cada pareja aparece dos veces. Divide por : quedan equipos.
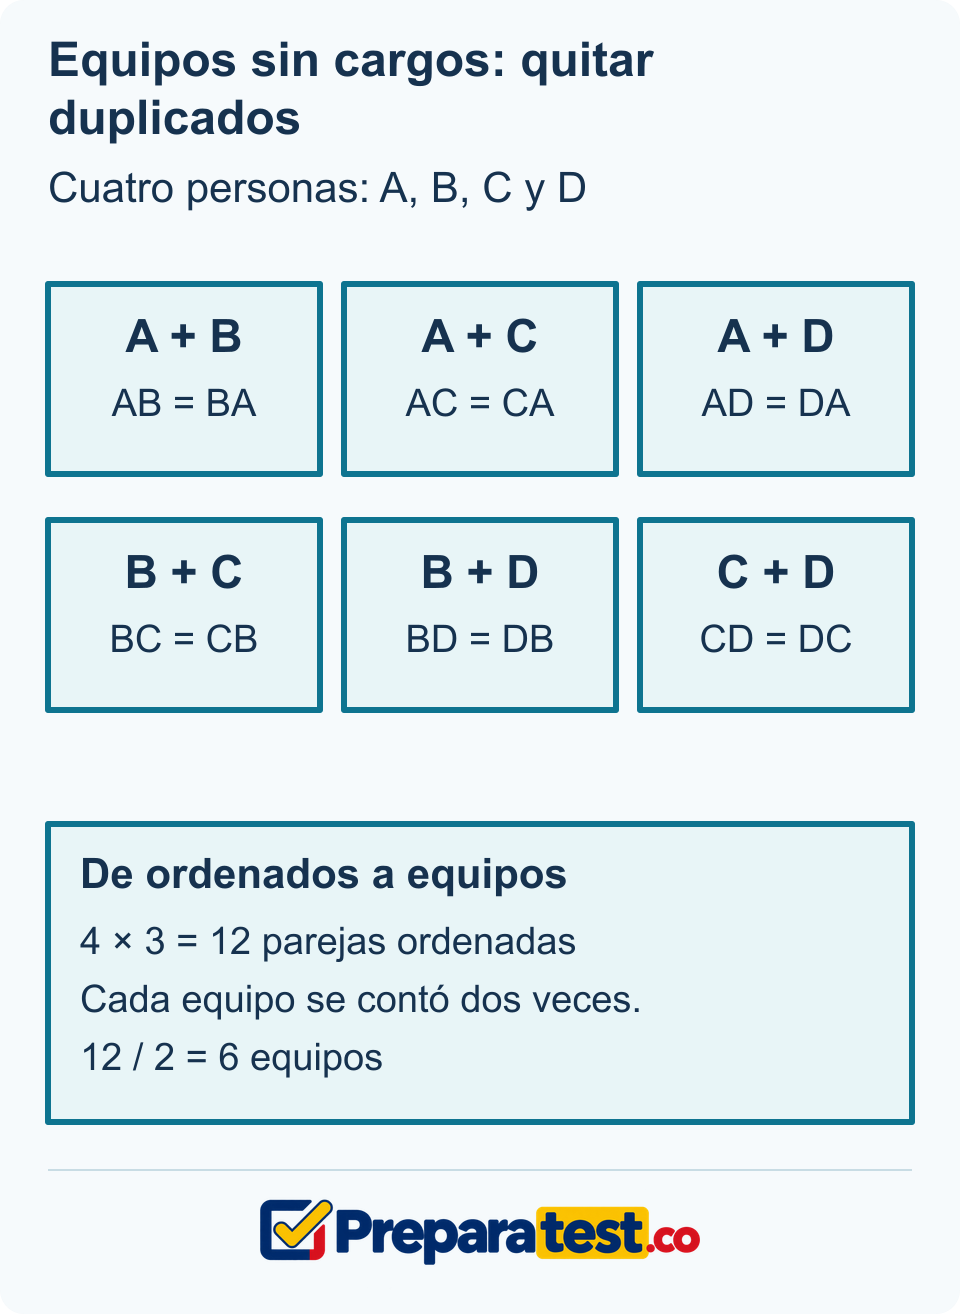
Las doce parejas ordenadas se agrupan de dos en dos. Cada pareja sin cargos cuenta una sola vez.
Las restricciones cambian el recuento. Un número de tres cifras no puede empezar por cero, mientras que un código sí podría hacerlo. Si dos alternativas se solapan, no se aplica la suma sin descontar lo repetido.
13. Experimentos aleatorios y espacios muestrales
Definir resultados elementales
Un experimento aleatorio tiene resultados posibles conocidos, pero no permite asegurar cuál ocurrirá en una realización. El espacio muestral, , contiene todos los resultados elementales. Un suceso es un subconjunto de esos resultados. Al lanzar dos monedas distinguibles, el espacio es , con C para cara y S para sello. “Exactamente una cara” reúne CS y SC.

Distinguir primera y segunda moneda evita perder resultados. Los cuatro casos tienen la misma probabilidad si las monedas son equilibradas y los lanzamientos independientes.
Cuando los resultados elementales son equiprobables, . Así, exactamente una cara tiene probabilidad . Si los resultados no son igualmente probables, contar y dividir no basta: hay que conocer o estimar sus probabilidades.
Las sumas de dos dados no son equiprobables
Al lanzar dos dados equilibrados e independientes, hay pares ordenados equiprobables. La suma 7 tiene seis pares favorables: (1,6), (2,5), (3,4), (4,3), (5,2) y (6,1). Por eso . La suma 12 solo aparece con (6,6), con probabilidad . No dividas entre las once sumas posibles suponiendo que todas ocurren igual.

Cada casilla representa un par de resultados y tiene probabilidad 1/36. Los colores permiten contar las casillas favorables sin confundir pares con sumas.
Probabilidad teórica y frecuencia experimental
La probabilidad teórica procede de un modelo. La frecuencia relativa experimental divide las veces que ocurre un suceso entre el número de ensayos. Obtener 12 caras en 20 lanzamientos da , aunque el modelo de moneda equilibrada asigne a cara. Bajo repeticiones independientes con probabilidad constante, las frecuencias tienden a estabilizarse cerca de esa probabilidad al aumentar mucho los ensayos; no están obligadas a coincidir en una muestra finita.
Tras varias caras seguidas, una moneda equilibrada e independiente sigue teniendo probabilidad 1/2 de cara en el siguiente lanzamiento. No tiene una “deuda” de sellos que deba compensar.
14. Complemento, unión y sucesos incompatibles
Probabilidades entre cero y uno
Toda probabilidad cumple . El suceso seguro tiene probabilidad 1 y el imposible, 0. En un espacio finito con resultados elementales equiprobables, la suma de todas sus probabilidades es 1. Si obtienes 1,2 o −0,3 al calcular una probabilidad, revisa el modelo y las operaciones.
El complemento permite calcular lo que no sucede: . Si una bolsa contiene ocho fichas igualmente seleccionables, tres naranjas y cinco azules, . Entonces , que coincide con contar directamente las cinco azules.

Un suceso y su complemento cubren todo el espacio y no se superponen. Sus probabilidades suman uno.
Sumar sin contar dos veces la intersección
La regla general de la unión es . En el curso de 30 estudiantes, la probabilidad de elegir al azar a alguien que practique fútbol o baloncesto es , es decir, . Se resta la intersección una sola vez porque al sumar se había contado dos veces.
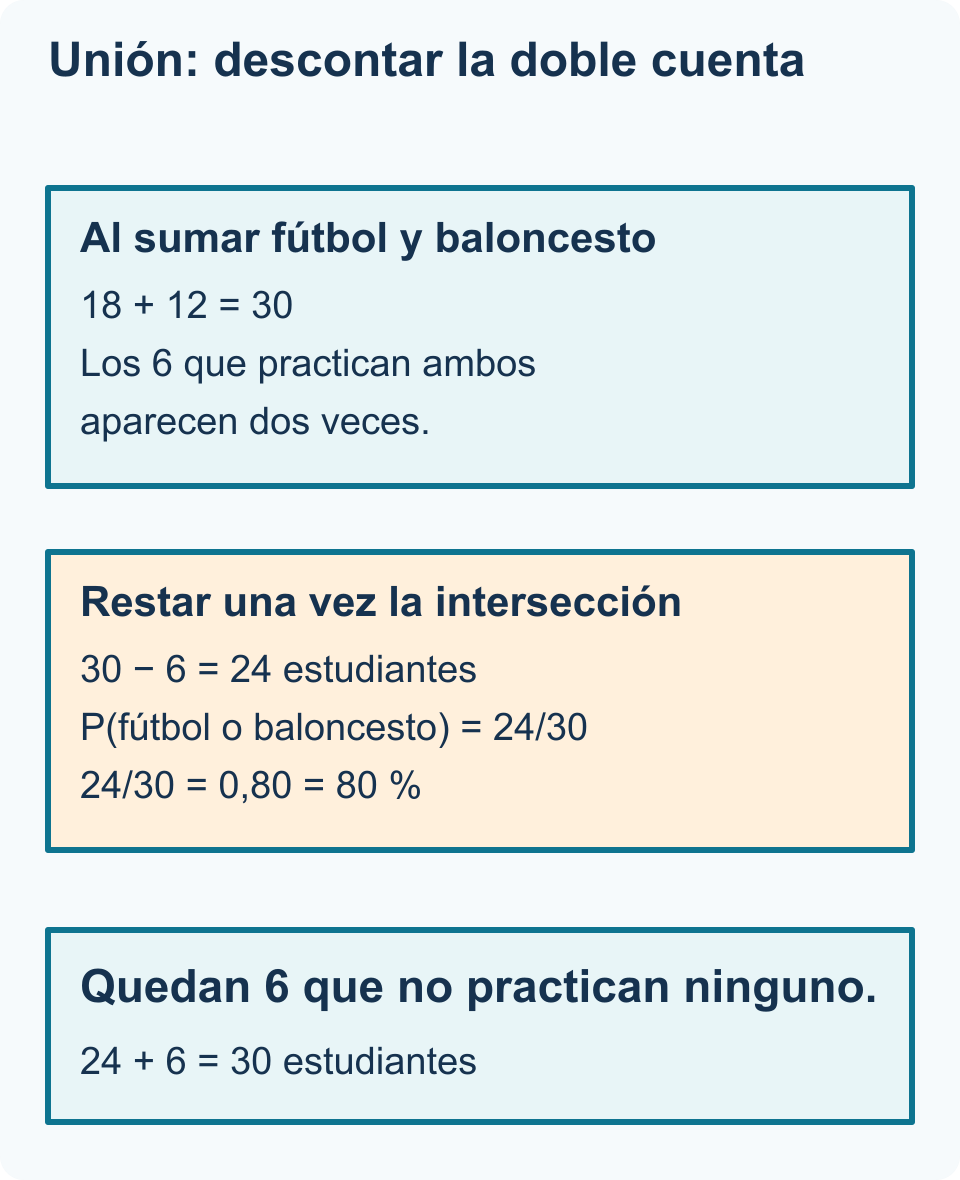
La palabra “o” incluye a quienes practican ambos deportes. El recuento 18 más 12 sin corrección daría una probabilidad de uno y excluiría erróneamente a los seis que no practican ninguno.
Dos sucesos son incompatibles o mutuamente excluyentes si no pueden ocurrir en el mismo ensayo: . En un único lanzamiento de dado, sacar 1 y sacar 6 son incompatibles, así que la probabilidad de uno u otro es . En cambio, “número par” y “número mayor que 4” sí se superponen en el 6.
15. Probabilidad condicionada: cambiar el grupo de referencia
El dato conocido reduce el espacio de comparación
La probabilidad de A dado que ocurrió B se escribe . Si , se calcula . Con personas igualmente seleccionables, equivale a dividir el número que cumple ambas condiciones entre el número que cumple B. La barra vertical se lee “dado que”; no es una división entre los nombres A y B.
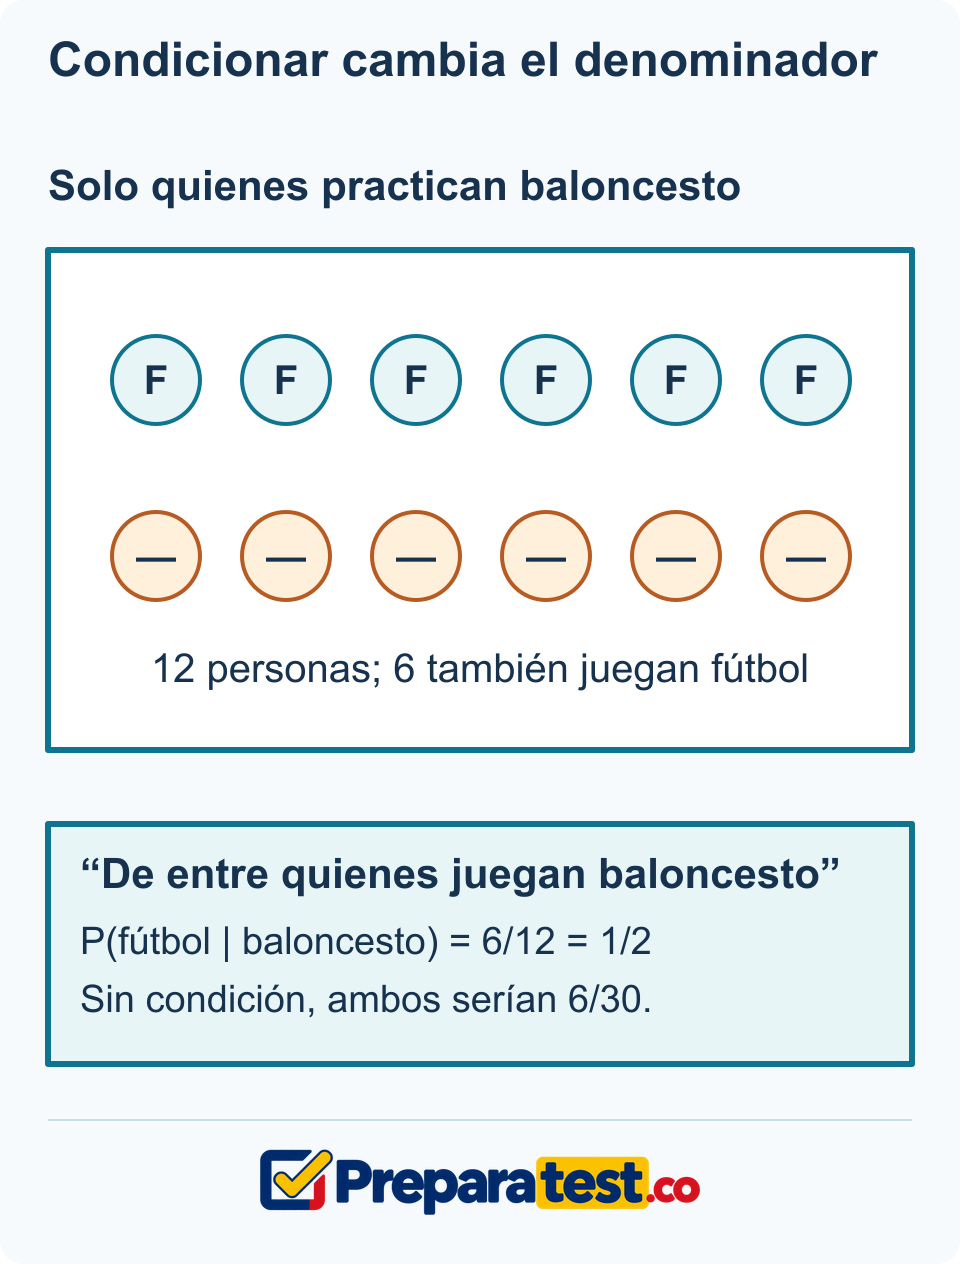
Si ya sabemos que la persona practica baloncesto, solo comparamos entre los doce de baloncesto. Los seis que también practican fútbol son la mitad de ese grupo.
- En el curso de 30, define A como practicar fútbol y B como practicar baloncesto. Hay 6 en ambos y 12 en B.
- La condición “practica baloncesto” fija el denominador en 12. Por tanto, .
- La probabilidad de practicar ambos, sin información previa, usa los 30: .
- Invertir la condición cambia el denominador: . No es lo mismo preguntar fútbol entre quienes juegan baloncesto que baloncesto entre quienes juegan fútbol.
Usar la regla del producto general
Despejando la fórmula anterior, . En el ejemplo, . También puedes escribir . Esta regla funciona sin exigir independencia; la segunda probabilidad ya incorpora la condición de la primera.
Antes de operar, completa la frase “de entre…”. “De entre todos los estudiantes” y “de entre quienes practican baloncesto” producen denominadores diferentes. Si el grupo condicionado tiene probabilidad cero, esta fórmula no define la probabilidad condicionada.
16. Independencia, reposición y árboles de probabilidad
La independencia mantiene la probabilidad
Dos sucesos son independientes cuando conocer uno no cambia la probabilidad del otro. Si , esto se expresa como , equivalente a . “Independientes” no significa “incompatibles”: sucesos incompatibles con probabilidades positivas no son independientes, porque al ocurrir uno el otro se vuelve imposible.
En una bolsa hay tres fichas azules y dos naranjas. Se elige una ficha al azar, se devuelve y se mezcla de nuevo antes de otra extracción con el mismo procedimiento. Con este modelo, la composición sigue siendo tres y dos en la segunda extracción; la reposición permite mantener las probabilidades.
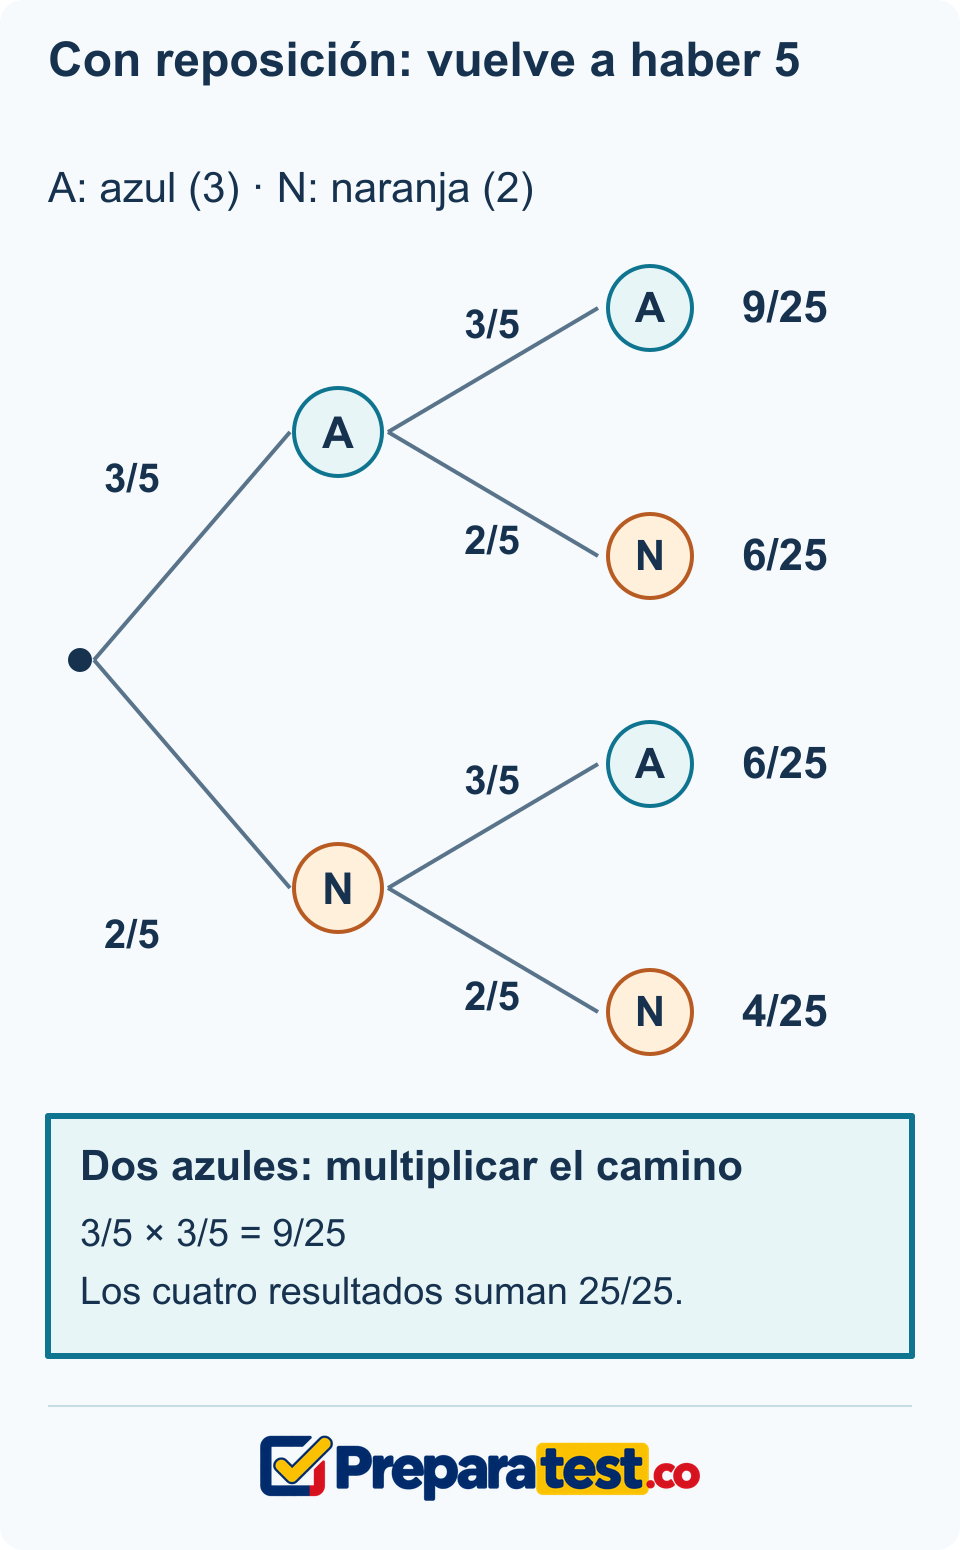
En cada punto del árbol, las ramas que salen suman uno. A lo largo de un camino se multiplica; para reunir caminos incompatibles se suman sus probabilidades.
- La probabilidad de azul en la primera extracción es . Con reposición y nueva mezcla, la de azul en la segunda sigue siendo .
- Para dos azules, multiplica: .
- Para colores diferentes hay dos caminos: azul-naranja y naranja-azul. Cada uno tiene probabilidad .
- Suma los caminos: . No son el mismo resultado ordenado, aunque ambos cumplen la condición de colores diferentes.
Sin reposición, la bolsa cambia
Si no devuelves la primera ficha, quedan cuatro. Después de sacar una azul quedan dos azules y dos naranjas; después de sacar una naranja quedan tres azules y una naranja. Las probabilidades de la segunda extracción dependen del primer resultado.

El denominador de la segunda extracción es cuatro. El numerador también se actualiza según el color retirado.
- Para dos azules sin reposición, calcula .
- Para azul-naranja: . Para naranja-azul: .
- Para colores diferentes, suma .
- Comprueba todos los caminos: .
La reposición mantiene la composición, pero la independencia del modelo también requiere una selección nueva sin dependencia del resultado anterior. Lee cómo se realiza el experimento; no multipliques probabilidades marginales por rutina.
17. Repeticiones: al menos uno y exactamente varios
El complemento simplifica “al menos uno”
Al lanzar dos veces un dado equilibrado de forma independiente, “al menos un seis” incluye exactamente un seis y dos seises. Su complemento es “ningún seis”. Cada lanzamiento tiene probabilidad de no mostrar seis; los dos juntos, . Restando al total, la probabilidad buscada es .

La fila y la columna del seis reúnen once casillas. La casilla (6,6) pertenece a ambas y solo se cuenta una vez.
“Exactamente un seis” es otra pregunta: hay cinco casos con seis solo en el primer dado y cinco con seis solo en el segundo, para un total de diez. Su probabilidad es . La diferencia con “al menos uno” es el caso (6,6).
Contar éxitos en ensayos independientes
Un ensayo de Bernoulli clasifica cada resultado como éxito o no éxito, sin que “éxito” signifique necesariamente algo deseable. Si repetimos un número fijo de ensayos independientes con la misma probabilidad de éxito, el número de éxitos sigue un modelo binomial. Estas condiciones son necesarias; extraer fichas sin reposición no mantiene, en general, una probabilidad constante.

En tres lanzamientos de moneda equilibrada, exactamente dos caras ocurre en CCS, CSC y SCC. Cada secuencia completa tiene probabilidad 1/8.
- Para exactamente dos caras en tres lanzamientos, elige sus posiciones: .
- Cada secuencia con dos caras y un sello tiene probabilidad .
- Las tres secuencias son incompatibles. Multiplica el número de secuencias por la probabilidad de cada una: .
En general, si X cuenta éxitos en ensayos y la probabilidad de éxito es , se usa . La combinación cuenta las posiciones de los éxitos; las potencias representan la probabilidad de una secuencia. Aquí , y . No hace falta memorizar la fórmula sin comprender esas dos partes.
18. Valor esperado e interpretación de resultados
Promediar resultados usando sus probabilidades
Una variable aleatoria asigna un número a cada resultado de un experimento. En una actividad se extrae al azar una de seis tarjetas: tres valen 0 puntos, dos valen 3 y una vale 6. La variable X es el número de puntos obtenidos. Las probabilidades de 0, 3 y 6 son, respectivamente, 1/2, 1/3 y 1/6.
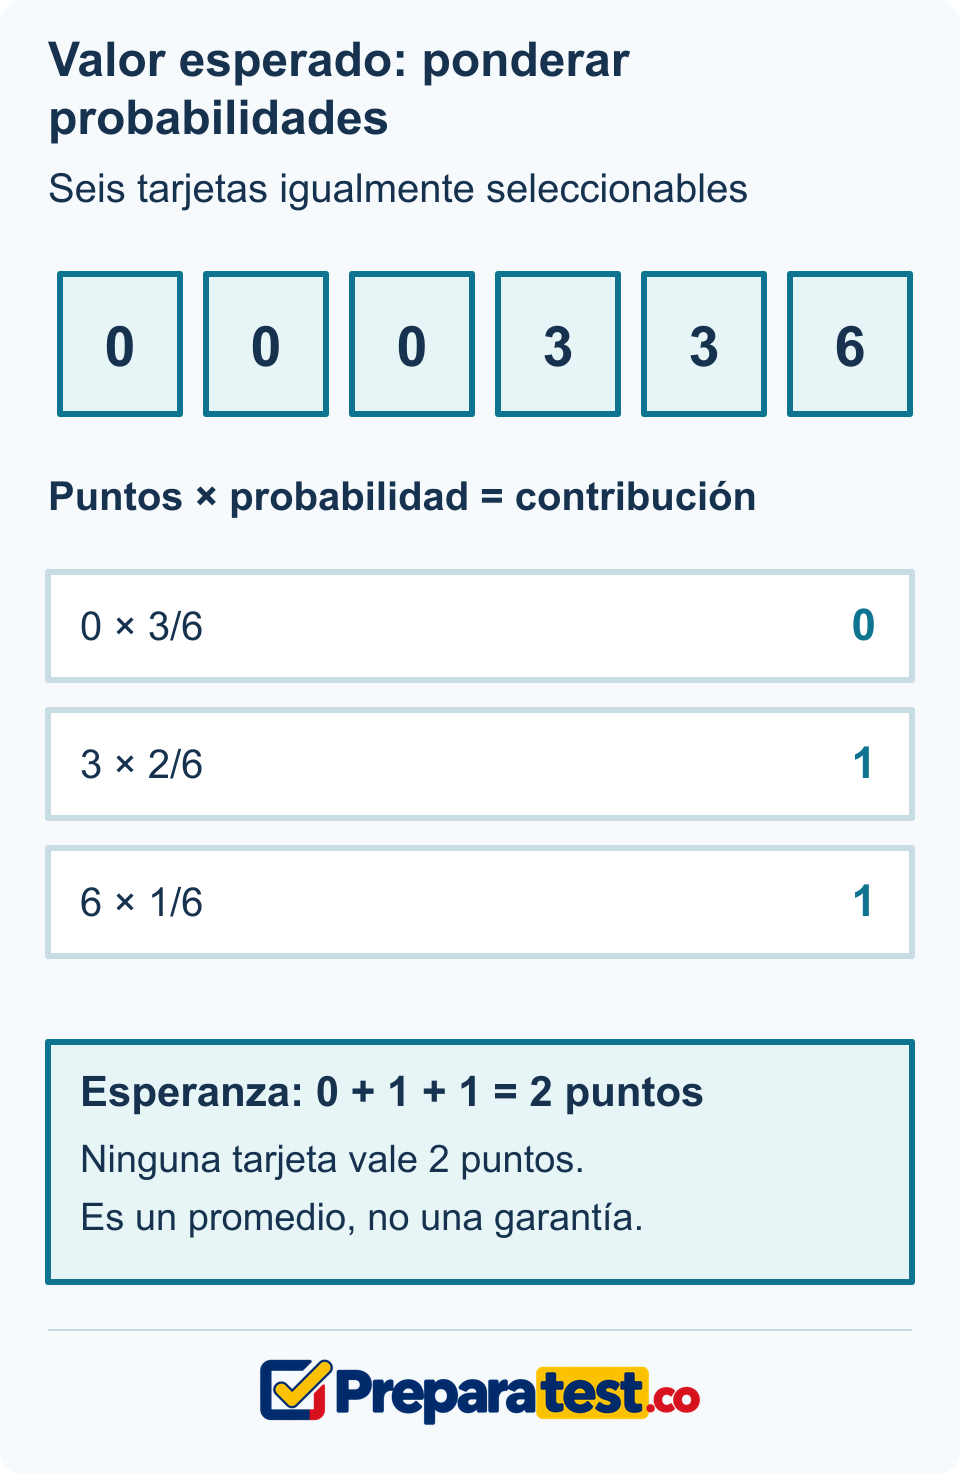
El valor esperado es un promedio ponderado por probabilidades. Puede ser un número que nunca se obtiene en una sola extracción.
- Comprueba que las probabilidades cubren todos los resultados: .
- Multiplica cada valor por su probabilidad: , y .
- Suma las contribuciones: puntos. La expresión general es .
- Si se repite 100 veces con reposición y el mismo mecanismo, el total esperado es puntos. El total real puede ser distinto.
Terminar con una conclusión que responda a la pregunta
Un cálculo estadístico requiere interpretación: precisa la población, la unidad y lo que permite afirmar. En probabilidad, identifica el experimento, el suceso y las condiciones del modelo. Comprueba si el resultado está en un rango razonable, si se ha contado algún caso dos veces y si se ha confundido una estimación con una garantía.
Un promedio esperado no predice con certeza una realización. Del mismo modo, una asociación no prueba causalidad y una muestra no describe automáticamente a toda la población. La calidad de la conclusión depende tanto del razonamiento como de la operación.
Ejemplos resueltos paso a paso
Ejemplo 1. Reconstruir un recuento desde un porcentaje
Planteamiento
En una encuesta a 80 estudiantes, el 35 % va caminando al colegio, el 40 % usa bus y el resto usa bicicleta. Cada estudiante elige una sola categoría. ¿Cuántos usan bicicleta?
Procedimiento y solución
- Las categorías son excluyentes y cubren todo el grupo. La proporción conocida es %.
- El porcentaje restante es %.
- Convierte 25 % en decimal: . Multiplica por el total: .
- Comprueba los otros recuentos: y . La suma recupera el total.
Resultado: 20 estudiantes usan bicicleta.
Interpretación y comprobación: El porcentaje se aplicó a los 80 estudiantes. No se restaron los números 35 y 40 directamente al recuento de personas.
Ejemplo 2. Comparar media, mediana y moda
Planteamiento
Cinco tiempos de espera son 4, 6, 6, 8 y 16 minutos. Calcula las tres medidas de centro y explica qué aporta cada una.
Procedimiento y solución
- La lista ya está ordenada. Su suma es minutos.
- Hay cinco tiempos: la media es minutos.
- La posición central es . El tercer dato es 6: esa es la mediana.
- El valor 6 aparece dos veces y los demás una: la moda también es 6.
- La media de 8 es mayor que la mediana de 6 porque el tiempo 16 eleva la suma. Comprueba .
Resultado: Media: 8 min; mediana: 6 min; moda: 6 min.
Interpretación y comprobación: Las medidas responden a preguntas distintas: reparto del total, posición central y valor más frecuente. El tiempo de 16 minutos debe verificarse, no descartarse solo por ser mayor.
Ejemplo 3. Combinar grupos de distinto tamaño
Planteamiento
Un grupo de 12 estudiantes resolvió en promedio 8 ejercicios y otro de 18 estudiantes resolvió en promedio 6. ¿Cuál es la media de los 30 estudiantes?
Procedimiento y solución
- Reconstruye los totales: ejercicios y .
- Suma las cantidades: ejercicios.
- Suma las personas: . Divide .
- La media debe quedar entre 6 y 8. Como el grupo con media 6 es mayor, el resultado queda más cerca de 6.
Resultado: 6,8 ejercicios por estudiante.
Interpretación y comprobación: Promediar 8 y 6 daría 7 y asignaría el mismo peso a grupos distintos. El peso correcto es el número de estudiantes.
Ejemplo 4. Estimar la media de un histograma
Planteamiento
Veinte tiempos se agrupan así: cuatro están entre 0 y 10 minutos, ocho entre 10 y 20, seis entre 20 y 30 y dos entre 30 y 40. El extremo izquierdo se incluye y el derecho se excluye. Estima la media.
Procedimiento y solución
- Usa los puntos medios como representantes: 5, 15, 25 y 35 minutos.
- Multiplica cada marca por la frecuencia: , , y .
- La suma ponderada es .
- Hay observaciones; la estimación es minutos.
Resultado: Media estimada: 18 minutos.
Interpretación y comprobación: No se puede asegurar la media exacta sin los tiempos individuales. El intervalo más frecuente es de 10 a 20 minutos, pero eso no convierte automáticamente su marca 15 en la media.
Ejemplo 5. Distinguir centro y dispersión
Planteamiento
Los cuatro valores 2, 2, 6 y 6 minutos constituyen la población completa que se analiza. Calcula su media, rango y desviación estándar poblacional.
Procedimiento y solución
- La media es minutos.
- El rango es minutos.
- Las diferencias respecto de la media son −2, −2, 2 y 2. Sus cuadrados suman .
- Como se describe la población completa, divide entre 4: .
- La desviación es . En este conjunto concreto todos los valores están a 2 minutos de la media.
Resultado: Media: 4 min; rango: 4 min; desviación estándar: 2 min.
Interpretación y comprobación: La coincidencia entre media y rango es numérica; representan aspectos distintos. Usar el divisor 3 correspondería a la varianza muestral corregida, que no es la solicitada.
Ejemplo 6. Obtener cuartiles y rango intercuartílico
Planteamiento
Los datos son 14, 4, 10, 2, 12, 6, 4 y 12. Usa el método de medianas de mitades para calcular los cuartiles y el rango intercuartílico.
Procedimiento y solución
- Ordena: 2, 4, 4, 6, 10, 12, 12, 14.
- Los dos centrales son 6 y 10: .
- En la mitad inferior, los centrales son 4 y 4: . En la superior son 12 y 12: .
- Resta los cuartiles extremos: . El rango total sería .
Resultado: , , ; .
Interpretación y comprobación: El rango intercuartílico mide el tramo central; el rango total usa los extremos. La regla de cálculo se declara para evitar discrepancias entre métodos.
Ejemplo 7. Contar y condicionar en una encuesta
Planteamiento
De 30 estudiantes, 18 practican fútbol, 12 baloncesto y 6 ambos. Se elige un estudiante uniformemente al azar. Calcula la probabilidad de que practique al menos uno y la de fútbol si sabemos que practica baloncesto.
Procedimiento y solución
- La unión contiene estudiantes; se descuenta la doble cuenta de los seis compartidos.
- Para al menos uno, el total de referencia es 30: .
- Con la condición de practicar baloncesto, el grupo de referencia tiene 12 estudiantes.
- De esos doce, seis practican fútbol: .
Resultado: Al menos un deporte: 80 %. Fútbol dado baloncesto: 50 %.
Interpretación y comprobación: La primera probabilidad usa todo el curso; la segunda, solo el grupo condicionado. La probabilidad de ambos sin condición sería 6/30, el 20 %.
Ejemplo 8. Elegir un equipo o asignar cargos
Planteamiento
De seis estudiantes se eligen dos. ¿Cuántas parejas sin cargos hay? ¿Cuántas asignaciones hay si uno será coordinador y el otro portavoz?
Procedimiento y solución
- Para cargos distintos, hay 6 opciones de coordinador y 5 de portavoz: .
- Para parejas sin cargos, cada pareja aparece dos veces en ese recuento: AB y BA.
- Divide entre : parejas.
- Comprueba con la combinación: .
Resultado: 15 parejas sin cargos y 30 asignaciones de cargos.
Interpretación y comprobación: La diferencia procede del orden, no de cambiar el grupo disponible. Una persona no ocupa ambos lugares porque la selección se hace sin repetición.
Ejemplo 9. Dos azules con y sin reposición
Planteamiento
Una bolsa contiene tres fichas azules y dos naranjas, igualmente seleccionables. Se extraen dos. Compara la probabilidad de dos azules si se devuelve la primera y se mezcla de nuevo, y si no se devuelve.
Procedimiento y solución
- La primera extracción tiene probabilidad de azul en ambos modelos.
- Con reposición, en la segunda siguen existiendo tres azules de cinco: .
- Sin reposición, después de una azul quedan dos azules de cuatro: .
- La diferencia es , es decir, 6 puntos porcentuales.
Resultado: Con reposición: 36 %. Sin reposición: 30 %.
Interpretación y comprobación: Retirar una azul reduce su proporción de 3/5 a 2/4, así que obtener una segunda azul resulta menos probable en este caso.
Ejemplo 10. Al menos un seis en dos lanzamientos
Planteamiento
Se lanza dos veces un dado equilibrado de forma independiente. ¿Cuál es la probabilidad de obtener al menos un seis?
Procedimiento y solución
- El complemento del suceso pedido es no obtener ningún seis.
- Cada lanzamiento evita el seis con probabilidad ; los dos lo evitan con probabilidad .
- Resta de uno: .
- Comprueba contando: 6 pares tienen seis en la primera posición y 6 en la segunda; (6,6) se contó dos veces, por lo que .
Resultado: , aproximadamente 30,56 %.
Interpretación y comprobación: Sumar 1/6 y 1/6 sin corregir la coincidencia daría 1/3 y contaría dos veces el resultado con dos seises.
Ejemplo 11. Exactamente dos aciertos independientes
Planteamiento
Una actividad tiene tres intentos independientes. En cada uno la probabilidad de acertar es 0,8. ¿Cuál es la probabilidad de acertar exactamente dos?
Procedimiento y solución
- La probabilidad de fallar es .
- Hay tres posiciones posibles para el único fallo: FEE, EFE y EEF, donde E es acierto.
- Cada secuencia tiene probabilidad .
- Suma las tres secuencias incompatibles: .
- Como comprobación, cero, uno, dos y tres aciertos tienen probabilidades 0,008; 0,096; 0,384 y 0,512. Su suma es 1.
Resultado: 38,4 %.
Interpretación y comprobación: Se usa un modelo binomial porque el número de intentos es fijo, la probabilidad no cambia y los intentos son independientes. Acertar dos o más incluiría también los tres aciertos y daría otro resultado.
Ejemplo 12. Revisar una afirmación de mayoría
Planteamiento
Un informe sobre una muestra aleatoria indica 52 % de apoyo y proporciona un margen de error de 4 puntos porcentuales al 95 % de confianza. Una persona afirma que está demostrado que la mayoría de la población apoya la propuesta. ¿La afirmación está justificada solo con esa información?
Procedimiento y solución
- Construye el intervalo usando el margen proporcionado: límite inferior % y superior %.
- La mayoría estricta requiere más de 50 %. El intervalo incluye 50 % y valores por debajo de 50 %.
- El 52 % describe la estimación de la muestra, pero el intervalo no permite sostener con claridad una mayoría poblacional.
- El 95 % de confianza se refiere a la cobertura del procedimiento en muestreos repetidos, no a que el 95 % de la población apoye la propuesta.
Resultado: La afirmación es demasiado fuerte para la información suministrada.
Interpretación y comprobación: El intervalo de 48 % a 56 % expresa incertidumbre e incluye tanto ausencia de mayoría como mayoría. El margen no se ha calculado aquí: es un dato del informe.
Errores frecuentes y cómo evitarlos
- Calcular la mediana antes de ordenar o confundir la posición central con el valor central.
- Promediar porcentajes o medias de grupos de distinto tamaño sin usar sus pesos.
- Interpretar una media agrupada como exacta aunque se hayan usado marcas de clase.
- Comparar únicamente alturas de histogramas con amplitudes distintas o ignorar un eje recortado.
- Confundir puntos porcentuales, porcentaje relativo y percentil.
- Cambiar entre varianza poblacional y muestral sin indicar qué se está calculando.
- Deducir causalidad de una correlación o creer que una muestra grande siempre es representativa.
- Sumar conjuntos superpuestos sin descontar la intersección.
- Usar casos favorables entre posibles cuando los resultados contados no son equiprobables.
- Mantener el denominador de toda la población en una probabilidad condicionada.
- Multiplicar probabilidades marginales sin comprobar independencia, o mantener la composición de una bolsa sin reposición.
- Confundir “al menos uno” con “exactamente uno”, o un valor esperado con un resultado seguro.
Lo que debes recordar
- Identifica población, muestra, variable, unidad y total de referencia antes de calcular.
- Comprueba que los recuentos, las frecuencias y los gráficos representan los mismos datos.
- La media usa la suma; la mediana usa el orden; la moda usa las repeticiones. Acompaña el centro con una medida de dispersión.
- Usa pesos para combinar notas, frecuencias o grupos; declara el método al calcular cuartiles y percentiles.
- El muestreo determina hasta dónde se puede generalizar. La incertidumbre y el sesgo son problemas diferentes.
- Distingue unión, intersección, inclusión y complemento. Decide si el orden y la repetición importan antes de contar.
- En un árbol, multiplica a lo largo de un camino y suma caminos incompatibles; actualiza las probabilidades cuando cambian las condiciones.
- Una probabilidad está entre cero y uno. Comprueba el cálculo con un recuento, un complemento o la suma de todos los casos cuando sea posible.
Autoevaluación: cinco preguntas originales
Elige una sola respuesta por pregunta y escribe el procedimiento que la justifica. Consulta las soluciones después de intentar resolverlas.
Pregunta 1
En un grupo, 5 estudiantes leyeron cero libros, 10 leyeron uno y 5 leyeron tres. ¿Cuántos libros leyó en promedio cada estudiante?
Pregunta 2
La lista ordenada es 2, 4, 4, 6, 10, 12, 12, 14. Usando medianas de mitades para los cuartiles, ¿qué afirmación es correcta?
- La mediana es 6 y el rango intercuartílico es 8.
- La mediana es 8 y el rango intercuartílico es 12.
- La mediana es 8 y el rango intercuartílico es 8.
- La mediana es 4 y el rango intercuartílico es 12.
Pregunta 3
De 40 estudiantes, 24 usan biblioteca, 18 usan laboratorio y 12 usan ambos. Se elige uniformemente al azar entre quienes usan laboratorio. ¿Cuál es la probabilidad de que también use biblioteca?
Pregunta 4
Una bolsa tiene cuatro fichas rojas y dos azules. Se extraen dos al azar sin reposición. ¿Cuál es la probabilidad de que ambas sean rojas?
Pregunta 5
Una encuesta voluntaria en el club de lectura de un colegio obtiene 500 respuestas y concluye que el 90 % de todo el colegio lee cada día. ¿Cuál es la objeción mejor fundamentada?
- Con 500 respuestas la conclusión es necesariamente representativa.
- La selección puede favorecer a quienes ya leen mucho; un tamaño grande no elimina ese sesgo.
- Una encuesta solo es válida si responde exactamente la mitad del colegio.
- El 90 % es imposible porque ninguna muestra puede superar el 50 %.
Respuestas y explicaciones
Compara cada paso con tu procedimiento y comprueba cómo se descartan las otras opciones.
Pregunta 1: opción B
- El total de estudiantes es .
- El total de libros es .
- Divide libros entre estudiantes: .
- La mediana es 1 porque las posiciones 10 y 11 corresponden a un libro, pero esa es otra medida.
La opción B usa las frecuencias. La opción A corresponde a la mediana y a la moda, pero no a la media; C promedia los tres valores distintos sin ponderarlos; D omite a quienes leyeron cero al contar personas y cambia el grupo de referencia.
Pregunta 2: opción C
- Los centrales de la lista son 6 y 10: la mediana es .
- La mitad inferior tiene mediana 4 y la superior, 12.
- El rango intercuartílico es .
- El rango total es , que no es lo solicitado.
La opción C distingue mediana, rango intercuartílico y rango total. A toma solo uno de los datos centrales; B usa el rango total como si fuera el intercuartílico; D confunde el primer cuartil con la mediana.
Pregunta 3: opción D
- La condición restringe la selección a los 18 estudiantes que usan laboratorio.
- Entre ellos, 12 también usan biblioteca.
- Calcula .
- Los otros 6 usuarios de laboratorio no usan biblioteca; .
La opción D usa el grupo condicionado de 18 usuarios de laboratorio. A calcula la probabilidad de ambos entre todos; B invierte la condición; C calcula la proporción de usuarios de biblioteca en todo el grupo.
Pregunta 4: opción A
- La primera roja tiene probabilidad .
- Si se retira una roja, quedan tres rojas entre cinco fichas: la segunda tiene probabilidad condicionada .
- Multiplica: .
- Comprueba por parejas sin orden: hay parejas rojas y parejas posibles; .
La opción A actualiza tanto el total como las rojas disponibles. B corresponde a devolver la primera ficha y repetir de forma independiente; C cuenta solo la primera extracción; D reduce las rojas pero mantiene incorrectamente seis fichas en la segunda.
Pregunta 5: opción B
- La población de interés es todo el colegio, pero la encuesta se concentra en un club relacionado con la conducta estudiada.
- Además, responder es voluntario: quienes participan pueden diferir de quienes no lo hacen.
- Las 500 respuestas describen al grupo que respondió; no corrigen automáticamente la selección.
- Para generalizar harían falta un diseño que cubra la población y una valoración de su incertidumbre y posibles sesgos.
La opción B identifica el problema de selección y el salto de la muestra a toda la población. A confunde cantidad con representatividad; C inventa un requisito de tamaño; D atribuye a los porcentajes un límite que no existe.
Cada pregunta de este tema lleva la competencia oficial, el apartado y la dificultad. Los tests del tema se activan cuando su banco de preguntas esté publicado.
Temas de Matemáticas
- Números y operaciones
- Álgebra y funciones
- Geometría plana
- Geometría espacial
- Estadística y probabilidad
- Resolución de problemas
Guarda tu avance
Crea tu cuenta gratis para seguir las cinco pruebas desde tu panel.
Crear cuenta gratis